Senast uppdaterad: 20 Aug, 2026
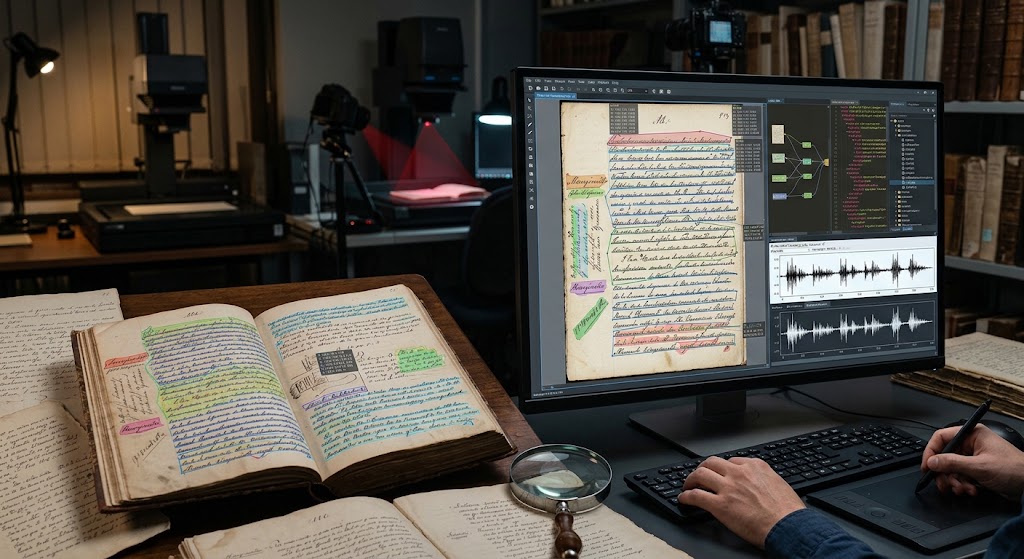
OCR-filformat för historiska och handskrivna dokument
Att bevara kulturarvet genom digitalisering har gått in i en renässans. Medan de tidiga optiska teckenigenkänningssystemen (OCR) konstruerades för att tolka oklanderlig, maskintryckt pappersdokument från 1900‑talet, står moderna kulturarvsinstitutioner inför en mycket rörigare och rikare utmaning: medeltida manuskript, 1800‑tals handskriven korrespondens, sköra upplysta folios och århundraden gamla register.
Att transkribera historiska dokument handlar inte längre bara om att extrahera vanlig ASCII‑text. Det kräver att man fångar kontext—sidans fysiska geometri, baslinjekurvor, korrigeringar för genomblödning, marginalia, förkortningar och paleografisk osäkerhet. Detta specialiserade område, ofta kategoriserat under Handwritten Text Recognition (HTR), är starkt beroende av det filformat som används för att lagra och utbyta både bildkoordinater och textlager.
Att välja fel schema kan ta bort viktig baslinjedata, bryta alignment med IIIF (International Image Interoperability Framework)-manifest eller hindra långsiktig digital bevarande. Här är en definitiv guide till de ledande OCR- och HTR‑filformaten för historiska dokument, deras strukturella styrkor och hur man avgör rätt val för din arkivpipeline.
Det historiska dilemmat: Varför Vanlig text och standard PDF-filer misslyckas
Maskintryckt OCR ger ofta enkla .txt‑filer eller “sandwich” PDFs med dolda textlager under skanningen. För historiska manuskript och kursiv handstil misslyckas dessa utdata av tre huvudorsaker:
- Icke-linjär text och komplexa layouter: Historiska skrivare följde inte rena rektangulära rutnät. Texten rinner in i marginalerna, omsluter upplysta initialer, väver sig mellan insatta interlinjära korrigeringar, eller löper vertikalt längs ryggraden.
- Kurviga och snedställda baslinjer: Kalligrafi följer sällan en stel horisontell axel. HTR-motorer som Transkribus, Kraken och eScriptorium förlitar sig på polylinje-baslinjer snarare än begränsningsrutor för att tolka ligaturtunga skript.
- Paleografisk komplexitet och metadata: Arkivforskning kräver spårning av förkortningar, historiska stavningsvarianter, skadade avläsningar och radnivåns konfidenspoäng. Standarddokumentformat kastar bort denna detaljrikedom.
För att bevara troheten mot det ursprungliga artefaktet förlitar sig arkivgemenskapen på strukturerade XML-scheman som är utformade för att bevara layoutens topologi tillsammans med transkriberad text.
1. PAGE XML: Gyllene standarden för handskriven textigenkänning (HTR)
Utvecklat av PRImA (Pattern Recognition & Image Analysis) Research Lab, PAGE XML (Page Analysis and Groundtruth Elements) anses allmänt vara det mest avancerade formatet för handskriven textigenkänning och avancerad layoutanalys.
Kärnarkitektur
PAGE XML behandlar det fysiska dokumentet som en hierarkisk struktur:
PcGts(Rot)Page(Bilddimensioner och övergripande läsordning)TextRegion(Paragrafer, rubriker, marginalanteckningar, kaptord)TextLineCoords(Polygonkoordinater runt linjen)Baseline(En serie punkter som följer den verkliga baslinjen för skriptet)TextEquiv(Den igenkända texten, med valfria förtroendemått)
Varför den utmärker sig för historiska manuskript
- Polygon- och polylinjeprecision: Istället för att tvinga tecken in i rektangulära avgränsningsrutor använder PAGE XML polygongränser med flera punkter och kontinuerliga baslinjer. Detta förhindrar att överlappande kursiva upphöjare och nedsänkningar stör segmenteringen.
- Granulära strukturella typer: Regioner kan klassificeras exakt (t.ex.
marginalia,drop-capital,signature-mark,header,editorial-note). - Brett mjukvaruekosystem: Det fungerar som det primära interna och exportschemat för flaggskepps-HTR-plattformar som Transkribus, eScriptorium och Kraken.
2. ALTO XML: Bibliotekets och arkivens kraftpaket
ALTO (Analyzed Layout and Text Object) är en öppen XML-standard som underhålls av Library of Congress och som har antagits brett av nationella bibliotek, inklusive Bibliothèque nationale de France (BnF) och British Library.
Kärnarkitektur
ALTO strukturerar layout hierarkiskt från Page till PrintSpace, ner till TextBlock, TextLine och String (individuella ord eller token). Det paketeras ofta i ett METS (Metadata Encoding and Transmission Standard)-omslag för att associera strukturell metadata med högupplösta originalbilder.
Viktiga styrkor och användningsområden
- Massdigitaliseringsarbetsflöden: ALTO designades med industriell skala för tidnings- och bokdigitalisering i åtanke. Det kodar tydligt teckensnittsattribut, koordinater på ordnivå, teckenkonfidens och mellanslag.
- Modern HTR-stöd (ALTO 4): Tidigare versioner av ALTO förlitade sig starkt på rektangulära koordinater (
HPOS,VPOS,WIDTH,HEIGHT). Men från och med ALTO version 4 introducerade schemat<Shape>-polygoner och polylinjebaslinjer, vilket stänger det funktionella gapet mot PAGE XML för handskrivet material. - Långsiktig bevarande: Eftersom det är en officiell standard som stöds av internationella biblioteks konsortier, garanterar ALTO långsiktig stabilitet och arkivklassad bakåtkompatibilitet.
3. hOCR: Den webb‑först, lätta standarden
Skapad av Thomas Breuel, hOCR tar ett pragmatiskt tillvägagångssätt: snarare än att skapa ett helt nytt XML-schema, inbäddar den layout- och transkriptionsmetadata direkt i semantisk HTML/XHTML med hjälp av mikroformat och klassattribut.
Exempel på typisk syntax
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">Incipit</span>
      </span>
    </p>
  </div>
</div>
Fördelar och nackdelar för historiska material
- Fördelar: Webbläsare kan rendera det nativt. Det kan enkelt transformeras med vanlig CSS och JavaScript, och det är standardformatet för strukturerad export för motorer som Tesseract.
- Nackdelar: Inbyggt stöd för komplexa, fria flerpunktsbaslinjekurvor är begränsat. Även om det är praktiskt för tidiga tryckta verk (incunabula eller rena bredblad), har hOCR svårt med oregelbundna manuskriptlayouter och flerskikts marginalia.
4. TEI-XML: Den akademiska och digitala humaniora‑referensstandarden
Formatet Text Encoding Initiative (TEI) är inte strikt ett OCR-motorutdataformat; snarare är det den främsta standarden för kritiska digitala utgåvor och vetenskaplig representation av litterära och historiska texter.
Koppla OCR/HTR till TEI
Moderna pipeline‑processer stannar sällan vid rå teckenigenkänning. Forskare använder verktyg som Transkribus TEI Exporter eller automatiserade XSLT‑pipeline för att översätta PAGE XML‑ eller ALTO‑filer till TEI‑kompatibel XML:
- Förkortningar expanderas (
<choice><abbr>...</abbr><expan>...</expan></choice>). - Raderingar, tillägg och skrivhandar klassificeras formellt (
<add>,<del>,<handShift>). - Layoutdata bevaras tillsammans med litterär analys via elementen
<facsimile>och<surface>.
Om ditt historiska projekt syftar till att skapa en interaktiv kritisk utgåva eller ett semantiskt sökbart vetenskapligt arkiv, är konvertering av dina OCR/HTR‑data till TEI‑XML ofta det nödvändiga sista steget.
Jämförande matris: OCR/HTR-format i översikt
| Funktion / Kriterium | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| Primär domän | Kursiv HTR & Manuskript | Massbibliotek digitalisering | Webb-OCR & Lättsökning | Vetenskapliga kritiska utgåvor |
| Grundläggande stöd | Inbyggda, flerpunktspolylinjer | Stöds (sedan v4.0) | Grundläggande (Lutning/Offset) | Via faksimilekartläggning |
| Oregelbundna polygoner | Full | Full | Begränsad | Via koordinatelement |
| Verktygs ekosystem | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, Webbläsare | Oxygen, TEI Publisher |
| Standardiseringsorgan | PRImA Group / Open | Library of Congress | Gemenskaps Specifikation | TEI-konsortiet |
Praktiska rekommendationer: Välja din arkivpipeline
För att etablera en effektiv, framtidssäker digitaliseringspipeline:
- För rena handskrivna manuskript och arkiv: Standardisera din transkription och layoututdrag på PAGE XML. Dess baslinjebereäkning och polygonkonturering hanterar icke-standardiserade skrivstilar med minimal dataförlust.
- För storskaliga bibliotek och blandade samlingar: Välj ALTO XML (v4.2 eller högre) i kombination med METS. Detta garanterar sömlös integration i standardarkitekturer för digitala arkiv och system för hantering av digitala tillgångar (DAMS).
- För webbpresentation och fulltextsökindex: Använd hOCR eller härleda lätta GeoJSON/Web Annotation-strukturer från PAGE XML för att driva interaktiva IIIF-visare (såsom Mirador eller Universal Viewer) med live textöverlägg i webbläsaren.
- För vetenskapliga utgåvor & paleografisk forskning: Generera ditt ground truth i PAGE XML, utför igenkänning och skicka utdata genom en automatiserad konverterare för att generera TEI-XML för redaktionell markup.
Genom att matcha de strukturella möjligheterna i dessa format med de paleografiska kraven på ditt källmaterial säkerställer du att varje streck, förkortning och historisk nyans förblir avkodningsbar i århundraden framöver.
Vanliga frågor (FAQ)
Q1. Vad är den grundläggande skillnaden mellan standard-OCR och HTR? OCR känner igen konsekvent maskintryckt typografi, medan HTR (Handwritten Text Recognition) använder djupa neurala nätverk för att avkoda kontinuerlig, variabel mänsklig handskrift och böjda baslinjer.
Q2. Kan Tesseract OCR producera PAGE XML eller ALTO-utdata för historiska dokument? Ja, Tesseract kan generera inbyggd ALTO XML och hOCR-utdata, och tredjeparts‑omslag kan konvertera dessa resultat till PAGE XML.
Q3. Varför är baslinjer viktigare än begränsningsrutor i transkription av handskrift? Baslinjer följer den naturliga, svallande linjen i mänsklig penningstil, vilket gör att mjukvaran kan separera överlappande upphöjda och sänkta tecken som kolliderar inom stela begränsningsrutor.
Q4. Hur interagerar IIIF-standarden med dessa OCR-filformat? IIIF levererar högupplösta bilder via öppna webb-API:er, medan format som ALTO eller PAGE XML tillhandahåller koordinatdata som kan konverteras till IIIF Content Search-annotationer.
Q5. Vilket filformat är enklast att konvertera direkt till en sökbar PDF? Både hOCR och ALTO XML kan kombineras med originalsidbilder för att skapa sökbara dubbla lager PDF-filer med verktyg som OCRmyPDF.