อัปเดตล่าสุด: 20 Aug, 2026
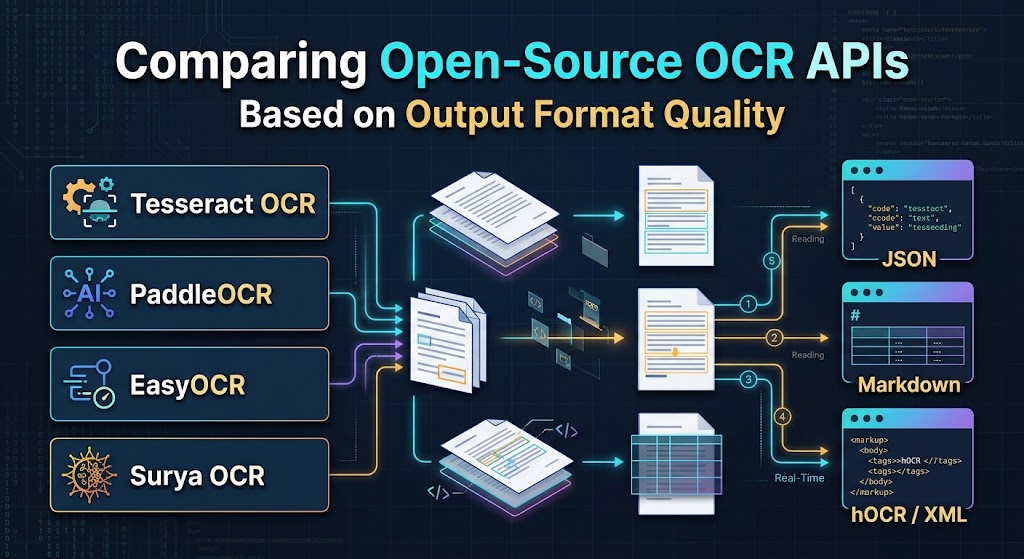
เปรียบเทียบ API OCR แบบโอเพนซอร์สตามคุณภาพรูปแบบผลลัพธ์
เมื่อวิศวกรประเมินเครื่องมือการจดจำอักขระด้วยแสง (OCR) ตัวชี้วัดอัตราความผิดพลาดของอักขระ (CER) และอัตราความผิดพลาดของคำ (WER) มักจะเป็นตัวกำหนดหลักในเกณฑ์การวัด แม้ว่าความแม่นยำของการจดจำจะสำคัญ แต่มันแก้ได้เพียงครึ่งหนึ่งของปัญหาในขั้นตอนการผลิต
หากคุณกำลังทำการแยกข้อมูลจาก PDF ที่ซับซ้อนหลายคอลัมน์ การสกัดรายการจากใบเสร็จรับเงิน หรือการนำเอกสารวิชาการเข้าสู่กระบวนการฝังข้อมูล LLM การดึงข้อความดิบออกมาจะสร้างภาระงานวิศวกรรมที่มหาศาล สตริงของอักขระที่ไม่มีการรับรู้การจัดวาง ลำดับการอ่านเชิงตรรกะ หรือข้อมูลพิกัด จะบังคับให้ทีมของคุณต้องเขียนตัวแยกข้อมูลเชิงอัลกอริทึมที่เปราะบาง
ตัวแยกความแตกต่างที่แท้จริงสำหรับกระบวนการทำงานกับเอกสารสมัยใหม่คือ คุณภาพรูปแบบผลลัพธ์: ความสม่ำเสมอและความสะอาดของการที่เครื่องมือส่งมอบพิกัด ลำดับการอ่าน โครงสร้างลำดับชั้น และข้อมูลตาราง
ด้านล่างเป็นการเปรียบเทียบที่มุ่งเน้นด้านวิศวกรรมของเครื่องมือ OCR แบบโอเพนซอร์ส สี่ตัวชั้นนำ—Tesseract, PaddleOCR, EasyOCR, และ Surya OCR—โดยประเมินว่าผลลัพธ์ของพวกมันทำงานอย่างไรภายในสายงานอัตโนมัติ
รูปแบบผลลัพธ์ทั่วไป: สิ่งที่วิศวกรต้องการจริงๆ
แต่ละ API OCR จะบรรจุข้อความที่ตรวจจับได้ในรูปแบบที่แตกต่างกัน การเข้าใจรูปแบบเหล่านี้ช่วยให้กำหนดได้ว่ากระบวนการหลังการประมวลผลของคุณต้องการเท่าใด:
- Plain Text (
.txt): ตัวแทนที่ง่ายที่สุด มันลบข้อมูลเมตาเชิงตำแหน่งทั้งหมดและรวมเลย์เอาต์หลายคอลัมน์ให้เป็นการอ่านแนวนอน ซึ่งอาจทำให้ย่อหน้าสับสน - Archival Standards (
hOCR,ALTO XML): รูปแบบที่อิง XML/HTML มาตรฐานในการจัดเก็บเอกสารของห้องสมุด พวกมันฝังพิกัด การประมาณฟอนต์ และคะแนนความเชื่อมั่นไว้ในโหนด DOM มีความทนทานสูงสำหรับการสร้างเอกสารใหม่ แต่มีขนาดใหญ่สำหรับไมโครเซอร์วิส - Structured JSON: ตัวเลือกเริ่มต้นสำหรับแบ็กเอนด์เว็บสมัยใหม่ ส่งอาร์เรย์พิกัด (กล่องขอบเขตหรือรูปหลายเหลี่ยม) คะแนนความเชื่อมั่น และโครงสร้างบล็อก/บรรทัด/คำแบบลำดับชั้น
- Markdown (
.md) / HTML Tables: มาตรฐานสมัยใหม่สำหรับ Retrieval-Augmented Generation (RAG) รักษาส่วนเชิงความหมาย (หัวเรื่อง, รายการ, ตัวหนา) และเมทริกซ์ตารางโดยไม่ต้องการการสร้างรูปแบบเชิงพื้นที่ต่อเนื่อง
1. Tesseract OCR
ได้รับการดูแลโดย Google, Tesseract ยังคงเป็นเครื่องมือหลักพื้นฐานของ OCR แบบโอเพ่นซอร์ส สถาปัตยกรรมของมันพึ่งพาอัลกอริธึมการแบ่งหน้าแบบดั้งเดิมอย่างหนัก พร้อมด้วยเครื่องยนต์อักขระที่ใช้ LSTM
รูปแบบผลลัพธ์ดั้งเดิม
- ผลลัพธ์หลัก: ข้อความธรรมดา, hOCR (HTML), ALTO XML, TSV (ค่าที่คั่นด้วยแท็บ), และ PDF/A ที่สามารถค้นหาได้.
- การรับรู้โครงร่าง: วิธีการเชิงกฎผ่านโหมดการแบ่งหน้า (PSM).
การวิเคราะห์รูปแบบผลลัพธ์
- จุดเด่น: การส่งออก
TSVและhOCRของ Tesseract มีมาตรฐานและคาดเดาได้ การส่งออก TSV เดียวจะคืนคอลัมน์ที่มีโครงสร้างสำหรับlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightและconf. หากคุณกำลังแปลงเอกสารกระดาษเป็น PDF ที่สามารถค้นหาได้หรือจำเป็นต้องปฏิบัติตามมาตรฐานสถาบันอย่างเคร่งครัด Tesseract จัดการเรื่องนี้โดยตรงโดยไม่ต้องใช้โค้ดเชื่อมต่อแบบกำหนดเอง. - ข้อจำกัด: Tesseract ไม่มี API JSON แบบเนทีฟ การใช้ผลลัพธ์ของมันใน Python หรือ Node.js ต้องการการแยกวิเคราะห์ไฟล์ XML/TSV หรือใช้ wrapper เช่น
pytesseract. เครื่องยนต์การจัดโครงร่างของมันยังมีปัญหากับการไหลของคอลัมน์ที่ไม่เป็นมาตรฐาน มักจะผสานข้อความจากคอลัมน์ที่อยู่ใกล้เคียงกัน หากไม่ได้มีการตัดกรอบด้วยมือ.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
ได้รับการสนับสนุนจากเฟรมเวิร์ก PaddlePaddle ของ Baidu, PaddleOCR ได้รับการยอมรับอย่างกว้างขวางเนื่องจากโมเดลที่มีน้ำหนักเบา, การครอบคลุมหลายภาษาอย่างครอบคลุม, และชุดเครื่องมือวิเคราะห์เอกสารเฉพาะ (PP-Structure).
รูปแบบผลลัพธ์ดั้งเดิม
- ผลลัพธ์หลัก: Python lists/dictionaries, raw JSON, visualization overlays, and structured HTML via PP-Structure.
- การรับรู้เค้าโครง: High (using deep learning models for layout parsing, orientation classification, and table recovery).
การวิเคราะห์รูปแบบผลลัพธ์
- จุดเด่น: Standard PaddleOCR returns 4-point polygon coordinates (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) alongside text strings and confidence scores. This handles skewed or curved text gracefully. However, its real strength lies in the PP-Structure suite, which detects layout regions (title, text, table, figure) and parses tables directly into valid HTML strings (<table>...</table>). This eliminates the need to manually compute cell spans from bounding boxes. - ข้อจำกัด: The base API returns nested arrays that lack standard property keys across different versions. For structured applications, developers usually write an intermediate adapter to standardize field names (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
สร้างบน PyTorch โดย JaegerAI, EasyOCR ถูกออกแบบเพื่อการนำไปใช้โดยนักพัฒนาที่รวดเร็ว. มันรวม CRAFT (Character Region Awareness for Text Detection) กับเครือข่ายการจดจำแบบ deep learning เข้าเป็น API ที่เรียบง่าย.
รูปแบบผลลัพธ์ดั้งเดิม
- ผลลัพธ์หลัก: รายการ Python ที่มีทูเพิลของพิกัด, สตริงที่ถูกจดจำ, และค่าความเชื่อมั่น.
- การรับรู้โครงร่าง: ต่ำถึงปานกลาง (ตรวจจับบรรทัดข้อความเท่านั้น; ไม่มีการแยกโครงสร้างระดับเอกสาร).
การวิเคราะห์รูปแบบผลลัพธ์
- จุดเด่น: ความเรียบง่ายของอ็อบเจกต์ที่ส่งกลับไม่มีใครเทียบได้:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
การแมปผลลัพธ์นี้ไปยังการตอบสนอง REST มาตรฐานหรือการทำซีเรียลไลซ์โดยตรงเป็น GeoJSON/สคีมาที่กำหนดเองใช้เพียงไม่กี่บรรทัดของโค้ดเท่านั้น มันทำงานอย่างเชื่อถือได้กับข้อความในฉากธรรมชาติ, ป้ายทะเบียนรถ, และการครอปเอกสารที่แยกออกมา.
- จุดอ่อน: EasyOCR ไม่ทำการวิเคราะห์โครงร่างเอกสารแบบองค์รวม มันไม่ระบุตาราง, ลำดับหัวเรื่อง, หรือลำดับการอ่านในคอลัมน์ที่ซับซ้อน การใช้ EasyOCR กับเอกสารวิชาการแบบสองคอลัมน์มักจะสร้างข้อความที่สลับกันอยู่ยาก หากไม่ได้จับคู่กับโมเดลตรวจจับโครงร่างต้นทาง (เช่น YOLO หรือ LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya เป็นเฟรมเวิร์ก OCR แบบ deep-learning สมัยใหม่ที่ออกแบบมาโดยเฉพาะสำหรับการทำความเข้าใจเอกสารที่ซับซ้อนและกระบวนการรับข้อมูล LLM.
รูปแบบผลลัพธ์แบบเนทีฟ
- ผลลัพธ์หลัก: โครงสร้าง JSON ที่โมเดลด้วย Pydantic, ดัชนีลำดับการอ่านเชิงตรรกะ, พื้นที่ขอบเขตของโครงร่าง, และรูปหลายเหลี่ยมการตรวจจับบรรทัด.
- การรับรู้เลย์เอาต์: สูงเป็นพิเศษ (การวิเคราะห์เลย์เอาต์โดยใช้ deep-learning และการจัดเรียงลำดับการอ่าน).
การวิเคราะห์รูปแบบผลลัพธ์
- จุดเด่น: Surya แก้ไขความท้าทายของการวิศวกรรม AI สมัยใหม่โดยตรง แทนที่จะสมมติว่าเอกสารอ่านจากบนลงล่าง ซ้ายไปขวา Surya ใช้โมเดลเฉพาะเพื่อทำนาย ลำดับการอ่าน มันจัดกลุ่มบรรทัดเป็นบล็อกเชิงความหมายที่มีตรรกะ จัดการกับการขยายหลายคอลัมน์อย่างเป็นธรรมชาติ และส่งออกโครงสร้างที่มีประเภทผ่าน Pydantic สิ่งนี้ทำให้การนำเข้าขั้นตอนต่อไปสู่ฐานข้อมูลเวกเตอร์และตัวแปลงเป็น Markdown เป็นไปโดยตรงและเชื่อถือได้.
- จุดอ่อน: ในฐานะกรอบงานที่ใหม่และหนักกว่าโดยใช้ PyTorch, Surya ต้องการการประมวลผล GPU เฉพาะเพื่อให้เทียบกับอัตราการทำงานของเอนจิน C++ ที่ปรับแต่งเช่น Tesseract หรือโมเดล Paddle ที่ถูกควอนไทซ์ มันไม่ได้มุ่งเป้าไปที่มาตรฐานการเก็บถาวรแบบเก่าเช่น hOCR หรือ ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
เมทริกซ์การเปรียบเทียบแบบหัวต่อหัว
| ความสามารถ / รูปแบบ | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| เนทีฟ hOCR / ALTO XML | การสนับสนุนแบบเนทีฟ | เฉพาะบุคคลที่สาม | ไม่มี | ไม่มี |
| เรขาคณิตกล่องขอบเขต | จัดแนวแกน (x, y, w, h) | รูปหลายเหลี่ยม 4 จุด | รูปหลายเหลี่ยม 4 จุด | รูปหลายเหลี่ยม + บล็อกเลย์เอาต์ |
| การแยกตาราง | TSV พิกัดเท่านั้น | สตริงตาราง HTML | ไม่มี | กริดพิกัดเซลล์ |
| การตรวจจับลำดับการอ่าน | อิงกฎ (หยุดเมื่อหลายคอลัมน์) | การวิเคราะห์การจัดวางด้วย ML | การจัดกลุ่มบรรทัดพื้นฐาน | โมเดลลำดับการอ่านเฉพาะ |
| สคีม่า JSON โดยตรง | ต้องการการแปลง | Python Dict / JSON | Python List / JSON | โมเดล Pydantic ที่กำหนดประเภท |
| เป้าหมาย downstream ที่เหมาะสม | PDF เก็บถาวร, DMS เก่า | ข้อมูลแบบฟอร์ม/ใบเสร็จ, ERP | สคริปต์ด่วน, ข้อความในฉาก | การรับข้อมูล LLM, สถาปัตยกรรม RAG |
คำแนะนำการทำงานต่อเนื่อง: ควรเลือกอันไหน?
- เลือก Tesseract หากข้อกำหนดการปฏิบัติตามของคุณต้องการผลลัพธ์ที่เป็นมาตรฐาน
hOCR,ALTO XML, หรือ PDF/A ที่สามารถค้นหาได้สำหรับบันทึกของรัฐบาลหรือเอกสารเก่า - เลือก PaddleOCR หากคุณกำลังประมวลผลเอกสารการเงินเชิงปฏิบัติการ (ใบแจ้งหนี้, ใบเสร็จ, แบบฟอร์มภาษี) ที่มีตารางซับซ้อนไม่มีขอบซึ่งต้องแปลงเป็น HTML หรือสเปรดชีต
- เลือก EasyOCR หากคุณต้องการไลบรารีที่เบาและเป็นสไตล์ Python เพื่อค้นหาและดึงข้อความจากภาพธรรมชาติ, ป้ายถนน, หรือส่วน UI ที่ถูกตัดโดยไม่ต้องกำหนดค่าซับซ้อน
- เลือก Surya OCR หากคุณกำลังป้อนรายงานธุรกิจที่ไม่มีโครงสร้าง, เอกสารวิจัย, และคู่มือเทคนิคเข้าสู่ LLM หรือเครื่องมือค้นหาเวกเตอร์ที่ลำดับการอ่านเชิงตรรกะและขอบเขตโครงสร้างที่ชัดเจนเป็นสิ่งสำคัญ
คำถามที่พบบ่อย (FAQ)
1. รูปแบบผลลัพธ์ OCR แบบโอเพ่นซอร์สใดที่ง่ายที่สุดในการป้อนเข้าสู่โมเดลภาษาใหญ่?
JSON ที่รับรู้ลำดับการอ่านของ Surya OCR และตาราง HTML ของ PaddleOCR PP-Structure ให้การแสดงผลที่สะอาดที่สุดสำหรับบริบทคำสั่งของ LLM และการทำดัชนี RAG
2. Tesseract สามารถสร้างการตอบสนองในรูปแบบ JSON ได้โดยตรงโดยไม่ต้องใช้เครื่องมือของบุคคลที่สามหรือไม่?
ไม่, Tesseract ส่งออกข้อความ, TSV, PDF, และ hOCR/ALTO XML โดยตรง; การสร้าง JSON จำเป็นต้องแปลงผลลัพธ์ TSV หรือ hOCR ด้วยตัวแปลงกลาง.
3. พิกัดรูปหลายเหลี่ยม 4 จุดแตกต่างจากกล่องขอบเขตที่จัดแนวตามแกนอย่างไร?
กล่องที่จัดแนวตามแกนใช้ [x, y, width, height] สมมติว่าข้อความเป็นแบน, ในขณะที่โพลิกอน 4 จุดให้คู่พิกัดสี่คู่เพื่อปิดล้อมข้อความที่หมุน, เอียง, หรือโค้งอย่างแม่นยำ.
4. เครื่องมือใดที่ส่งออกโครงสร้างตารางโดยตรงเป็นโค้ดแทนการส่งออกพิกัดแบบหลวม?
โมดูล PP-Structure ของ PaddleOCR สร้างขอบตารางที่ตรวจจับใหม่เป็นแท็กตาราง HTML ครบรูปแบบ (<table>, <tr>, <td>), เพื่อหลีกเลี่ยงการคำนวณเชิงพื้นที่แบบกำหนดเอง.
5. ทำไมผลลัพธ์ของ EasyOCR มาตรฐานจึงประสบปัญหาในการจัดการกับเอกสารวิทยาศาสตร์หลายคอลัมน์?
EasyOCR ระบุบรรทัดข้อความโดยอิงจากความใกล้ชิดในท้องถิ่นแทนลำดับชั้นการจัดวางทั่วโลก, ทำให้ข้อความจากคอลัมน์ที่อยู่ใกล้เคียงผสมกันเว้นแต่จะถูกจำกัดโดยเครื่องมือจัดวางภายนอก.