อัปเดตล่าสุด: 20 Aug, 2026
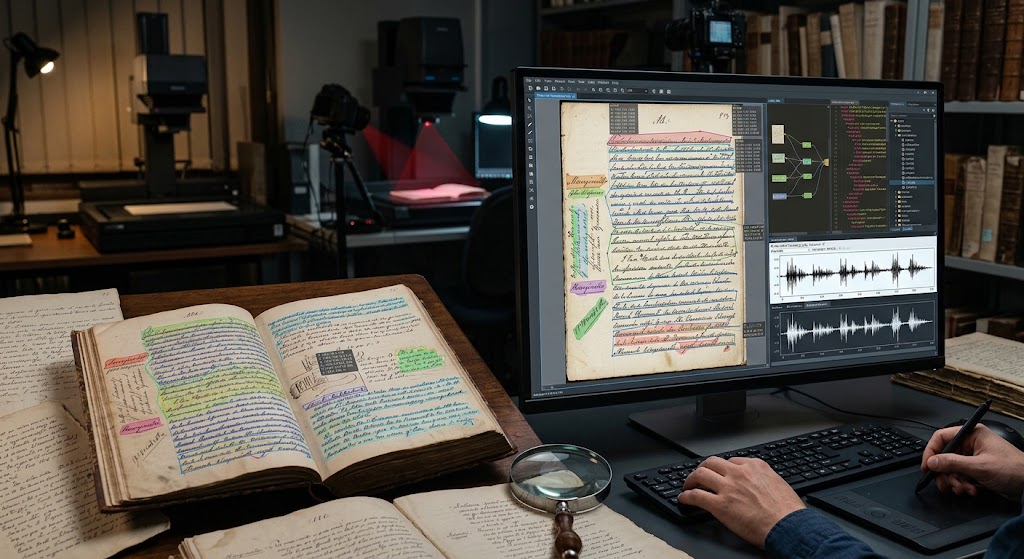
รูปแบบไฟล์ OCR สำหรับเอกสารประวัติศาสตร์และลายมือ
การอนุรักษ์มรดกวัฒนธรรมผ่านการดิจิไทเซชันได้เข้าสู่ยุคฟื้นฟูใหม่ ในขณะที่ระบบการจดจำอักขระด้วยแสง (OCR) รุ่นแรกถูกออกแบบมาเพื่อประมวลผลเอกสารที่พิมพ์ด้วยเครื่องในศตวรรษที่ 20 ที่สะอาดและสมบูรณ์แบบ สถาบันมรดกวัฒนธรรมสมัยใหม่ต้องเผชิญกับความท้าทายที่ซับซ้อนและหลากหลายยิ่งขึ้น: ต้นฉบับกลางยุคกลาง, จดหมายลายมือโค้งของศตวรรษที่ 19, ใบพับส่องสว่างที่เปราะบาง, และทะเบียนที่มีอายุหลายศตวรรษ
การถอดความเอกสารประวัติศาสตร์ไม่ได้เป็นเพียงการสกัดข้อความ ASCII ธรรมดาอีกต่อไปแล้ว มันต้องการการจับ context—รูปทรงกายภาพของหน้า, เส้นโค้งฐาน, การแก้ไขการรั่วซึมของหมึก, หมายเหตุขอบ, คำย่อ, และความไม่แน่นอนด้านพาลีโอกราฟี. สาขาพิเศษนี้ซึ่งมักจัดอยู่ภายใต้การจดจำข้อความลายมือ (Handwritten Text Recognition (HTR)) พึ่งพาอย่างมากกับรูปแบบไฟล์ที่ใช้ในการจัดเก็บและแลกเปลี่ยนทั้งพิกัดภาพและชั้นข้อความ.
การเลือกสคีมาที่ไม่เหมาะสมอาจทำให้ข้อมูลฐานสำคัญหายไป, ทำให้การจัดตำแหน่งกับเมนิเฟสต์ของ IIIF (International Image Interoperability Framework) แตกหัก, หรือขัดขวางการเก็บรักษาดิจิทัลระยะยาว นี่คือคู่มือที่ชัดเจนเกี่ยวกับรูปแบบไฟล์ OCR และ HTR ชั้นนำสำหรับเอกสารประวัติศาสตร์, จุดแข็งด้านโครงสร้างของแต่ละรูปแบบ, และวิธีการกำหนดตัวเลือกที่เหมาะสมสำหรับกระบวนการจัดเก็บของคุณ.
ปริศนาประวัติศาสตร์: ทำไม ข้อความธรรมดา และ ไฟล์ PDF ถึงล้มเหลว
OCR ที่พิมพ์ด้วยเครื่องมักจะส่งออกไฟล์ .txt อย่างง่ายหรือ PDF แบบ “sandwich” ที่มีชั้นข้อความซ่อนอยู่ใต้การสแกน สำหรับต้นฉบับประวัติศาสตร์และลายมือเชื่อมต่อ, ผลลัพธ์เหล่านี้ล้มเหลวเนื่องจากสามเหตุผลหลัก:
- ข้อความที่ไม่เป็นเชิงเส้นและการจัดหน้าแบบซับซ้อน: นักเขียนประวัติศาสตร์ไม่ได้ยึดตามกริดสี่เหลี่ยมที่เรียบร้อย ข้อความไหลลงสู่ขอบกระดาษ, พันรอบอักษรต้นที่ส่องสว่าง, สานต่อระหว่างการแก้ไขแบบแทรกบรรทัด, หรือวิ่งแนวตั้งตามกระดูกสันหลัง.
- เส้นฐานโค้งและเอียง: การเขียนลายมือมักไม่ปฏิบัติตามแกนแนวนอนที่ตายตัว เครื่องมือ HTR เช่น Transkribus, Kraken, และ eScriptorium พึ่งพาเส้นฐานแบบโพลีไลน์แทนกล่องขอบเขตเพื่อแปลสคริปต์ที่มีลิการ์จำนวนมาก.
- ความซับซ้อนของพาลีโอกราฟีและเมตาดาต้า: การวิจัยเอกสารเก่า จำเป็นต้องติดตามคำย่อ, ความแตกต่างของการสะกดในประวัติศาสตร์, การอ่านที่เสียหาย, และคะแนนความเชื่อมั่นระดับบรรทัด รูปแบบเอกสารมาตรฐานมักละทิ้งความละเอียดนี้.
เพื่อรักษาความถูกต้องของวัตถุต้นฉบับ ชุมชนการจัดเก็บเอกสารอิงค์พึ่งพาโครงสร้าง XML ที่ออกแบบมาเพื่อคงรูปแบบการจัดหน้าไว้พร้อมกับข้อความที่ถอดความแล้ว.
1. PAGE XML: มาตรฐานทองคำสำหรับการจดจำข้อความลายมือ (HTR)
พัฒนาโดยห้องปฏิบัติการวิจัย PRImA (Pattern Recognition & Image Analysis) PAGE XML (Page Analysis and Groundtruth Elements) ถือเป็นรูปแบบที่ล้ำสมัยที่สุดสำหรับการจดจำข้อความลายมือและการวิเคราะห์การจัดหน้าเชิงลึก.
สถาปัตยกรรมหลัก
PAGE XML ปฏิบัติกับเอกสารทางกายภาพเป็นโครงสร้างแบบลำดับชั้น:
PcGts(ราก)Page(มิติของภาพและลำดับการอ่านโดยรวม)TextRegion(ย่อหน้า, หัวเรื่อง, หมายเหตุขอบ, คำจับ)TextLineCoords(พิกัดรูปหลายเหลี่ยมรอบเส้น)Baseline(ชุดของจุดที่ตามเส้นฐานจริงของข้อความ)TextEquiv(ข้อความที่ได้รับการจดจำ พร้อมเมตริกความเชื่อมั่นแบบเลือก)
ทำไมมันจึงโดดเด่นสำหรับต้นฉบับประวัติศาสตร์
- ความแม่นยำของโพลิกอนและโพลีไลน์: แทนที่จะบังคับอักขระให้เข้าสู่กล่องสี่เหลี่ยม, PAGE XML ใช้ขอบเขตโพลิกอนหลายจุดและเส้นฐานต่อเนื่อง. สิ่งนี้ช่วยป้องกันไม่ให้ส่วนหัวและส่วนท้ายของตัวอักษรเชิงลายที่ทับซ้อนกันรบกวนการแบ่งส่วน.
- ประเภทโครงสร้างแบบละเอียด: พื้นที่สามารถจำแนกได้อย่างแม่นยำ (เช่น
marginalia,drop-capital,signature-mark,header,editorial-note). - ระบบซอฟต์แวร์ที่กว้างขวาง: มันทำหน้าที่เป็นสคีมาภายในและส่งออกหลักสำหรับแพลตฟอร์ม HTR ชั้นนำเช่น Transkribus, eScriptorium, และ Kraken.
2. ALTO XML: ศูนย์พลังของห้องสมุดและการจัดเก็บเอกสาร
ALTO (Analyzed Layout and Text Object) เป็นมาตรฐาน XML แบบเปิดที่ดูแลโดยหอสมุดรัฐสภา (Library of Congress) และได้รับการนำไปใช้โดยหอสมุดแห่งชาติอย่างกว้างขวาง รวมถึง Bibliothèque nationale de France (BnF) และ British Library.
สถาปัตยกรรมหลัก
ALOTO จัดโครงสร้างเลย์เอาต์เป็นลำดับชั้นจาก Page ไปยัง PrintSpace แล้วต่อไปยัง TextBlock, TextLine และ String (คำหรือโทเคนแต่ละรายการ) มักจะถูกบรรจุอยู่ในห่อ METS (Metadata Encoding and Transmission Standard) เพื่อเชื่อมโยงเมตาดาต้าเชิงโครงสร้างกับภาพมาสเตอร์ความละเอียดสูง
จุดแข็งหลักและกรณีการใช้งาน
- กระบวนการดิจิไทเซชันแบบมวล: ALTO ถูกออกแบบโดยคำนึงถึงการดิจิไทเซชันหนังสือพิมพ์และหนังสือในระดับอุตสาหกรรม มันเข้ารหัสคุณลักษณะของฟอนต์, พิกัดระดับคำ, ความมั่นใจของอักขระ, และช่องว่างอย่างชัดเจน.
- การสนับสนุน HTR สมัยใหม่ (ALTO 4): เวอร์ชันก่อนของ ALTO พึ่งพาพิกัดสี่เหลี่ยมผืนผ้าอย่างมาก (
HPOS,VPOS,WIDTH,HEIGHT). อย่างไรก็ตาม ตั้งแต่ ALTO เวอร์ชัน 4, สคีมานำเสนอรูปหลายเหลี่ยม<Shape>และเส้นฐานโพลีไลน์, ปิดช่องว่างด้านฟังก์ชันกับ PAGE XML สำหรับวัสดุที่เขียนด้วยมือ. - การเก็บรักษาระยะยาว: เนื่องจากเป็นมาตรฐานอย่างเป็นทางการที่ได้รับการสนับสนุนจากกลุ่มหอสมุดระดับนานาชาติ, ALTO รับประกันความเสถียรระยะยาวและความเข้ากันได้ย้อนหลังในระดับการเก็บถาวร.
3. hOCR: มาตรฐานแบบเว็บ-เป็นอันดับแรกและน้ำหนักเบา
สร้างโดย Thomas Breuel, hOCR ใช้วิธีการเชิงปฏิบัติ: แทนที่จะสร้างสคีม่า XML ใหม่ทั้งหมด, มันฝังเมตาดาต้าเลย์เอาต์และการถอดความโดยตรงลงใน HTML/XHTML เชิงความหมายโดยใช้ไมโครฟอร์แมตและแอตทริบิวต์คลาส.
ตัวอย่างไวยากรณ์ทั่วไป
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">Incipit</span>
      </span>
    </p>
  </div>
</div>
ข้อดีและข้อเสียสำหรับวัสดุประวัติศาสตร์
- ข้อดี: เบราว์เซอร์สามารถแสดงผลได้โดยตรง. สามารถแปลงได้ง่ายโดยใช้ CSS และ JavaScript ธรรมดา, และเป็นรูปแบบการส่งออกโครงสร้างเริ่มต้นสำหรับเอนจินเช่น Tesseract.
- ข้อเสีย: การสนับสนุนโดยเนทีฟสำหรับเส้นโค้งฐานหลายจุดที่ซับซ้อนและอิสระมีจำกัด. แม้ว่าจะเหมาะสำหรับงานพิมพ์ยุคแรก (incunabula หรือโบรสไดด์ที่สะอาด), hOCR มีปัญหาในการจัดการกับเลย์เอาต์ต้นฉบับที่ไม่เป็นระเบียบและหมายเหตุขอบหลายชั้น.
4. TEI-XML: มาตรฐานอ้างอิงสำหรับการศึกษาและมนุษยศาสตร์ดิจิทัล
รูปแบบ Text Encoding Initiative (TEI) ไม่ได้เป็นรูปแบบผลลัพธ์ของเครื่อง OCR อย่างเคร่งครัด; แต่เป็นมาตรฐานชั้นนำสำหรับฉบับดิจิทัลเชิงวิจารณ์และการนำเสนอเชิงวิชาการของข้อความวรรณกรรมและประวัติศาสตร์
การเชื่อมต่อ OCR/HTR กับ TEI
สายงานสมัยใหม่มักไม่หยุดที่การรับรู้ตัวอักษรดิบ นักวิชาการใช้เครื่องมือเช่น Transkribus TEI Exporter หรือสายงาน XSLT อัตโนมัติเพื่อแปลงไฟล์ PAGE XML หรือ ALTO ให้เป็น XML ที่สอดคล้องกับ TEI:
- คำย่อจะถูกขยาย (
<choice><abbr>...</abbr><expan>...</expan></choice>). - การลบ, การเพิ่ม, และลายมือของผู้คัดลายจะถูกจัดประเภทอย่างเป็นทางการ (
<add>,<del>,<handShift>). - ข้อมูลการจัดหน้าได้รับการเก็บรักษาพร้อมกับการวิเคราะห์วรรณกรรมผ่านองค์ประกอบ
<facsimile>และ<surface>.
หากโครงการประวัติศาสตร์ของคุณมุ่งสร้างฉบับวิจารณ์แบบโต้ตอบหรือคลังข้อมูลเชิงวิชาการที่สามารถค้นหาเชิงความหมายได้ การแปลงข้อมูล OCR/HTR ของคุณเป็น TEI-XML มักเป็นขั้นตอนสุดท้ายที่จำเป็น
เมทริกซ์เปรียบเทียบ: รูปแบบ OCR/HTR อย่างรวดเร็ว
| คุณลักษณะ / เกณฑ์ | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| โดเมนหลัก | HTR ตัวเขียนลายมือ & ต้นฉบับ | การดิจิไทซ์ห้องสมุดขนาดใหญ่ | OCR เว็บ & การค้นหาเบา | ฉบับวิจารณ์เชิงวิชาการ |
| การสนับสนุนพื้นฐาน | พื้นฐาน, โพลีไลน์หลายจุด | รองรับ (ตั้งแต่เวอร์ชัน 4.0) | พื้นฐาน (ความชัน/ออฟเซ็ต) | ผ่านการแมปแบบฟากซิมิลี |
| รูปหลายเหลี่ยมไม่สม่ำเสมอ | เต็ม | เต็ม | จำกัด | ผ่านองค์ประกอบพิกัด |
| ระบบนิเวศเครื่องมือ | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, ตัวดูเว็บ | Oxygen, TEI Publisher |
| หน่วยงานมาตรฐาน | PRImA Group / Open | หอสมุดรัฐสภา | ข้อกำหนดชุมชน | คอนซอร์เทียม TEI |
คำแนะนำเชิงปฏิบัติ: การเลือกกระบวนการจัดเก็บเอกสารของคุณ
เพื่อสร้างกระบวนการดิจิไทเซชันที่มีประสิทธิภาพและพร้อมสำหรับอนาคต:
- สำหรับต้นฉบับและเอกสารมือเขียนดั้งเดิม: มาตรฐานการถอดความและการสกัดเลย์เอาต์ของคุณบน PAGE XML. การคำนวณเส้นฐานและการกำหนดรูปหลายเหลี่ยมของมันจัดการกับลายมือที่ไม่เป็นมาตรฐานได้โดยสูญเสียข้อมูลน้อยที่สุด.
- สำหรับห้องสมุดขนาดใหญ่และคอลเลกชันผสม: เลือก ALTO XML (v4.2 หรือสูงกว่า) คู่กับ METS. สิ่งนี้รับประกันการบูรณาการที่ราบรื่นเข้าสู่สถาปัตยกรรมคลังดิจิทัลมาตรฐานและระบบการจัดการสินทรัพย์ดิจิทัล (DAMS).
- สำหรับการนำเสนอเว็บและดัชนีการค้นหาเต็มข้อความ: ใช้ hOCR หรือสร้างโครงสร้าง GeoJSON/Web Annotation ที่มีน้ำหนักเบาจาก PAGE XML เพื่อขับเคลื่อนตัวดู IIIF แบบโต้ตอบ (เช่น Mirador หรือ Universal Viewer) พร้อมกับการซ้อนทับข้อความแบบเรียลไทม์ในเบราว์เซอร์.
- สำหรับการตีพิมพ์เชิงวิชาการและการวิจัยพาเลโอกราฟี: สร้างข้อมูลพื้นฐานของคุณในรูปแบบ PAGE XML, ทำการจดจำ, และส่งผลลัพธ์ผ่านตัวแปลงอัตโนมัติเพื่อสร้าง TEI-XML สำหรับการทำเครื่องหมายเชิงบรรณาธิการ.
โดยการจับคู่ความสามารถเชิงโครงสร้างของรูปแบบเหล่านี้กับความต้องการพาเลโอกราฟีของวัสดุต้นฉบับของคุณ คุณจะทำให้ทุกเส้น, คำย่อ, และนัยสำคัญทางประวัติศาสตร์ยังคงสามารถถอดรหัสได้ตลอดหลายศตวรรษข้างหน้า.
คำถามที่พบบ่อย (FAQ)
Q1. ความแตกต่างพื้นฐานระหว่าง OCR มาตรฐานและ HTR คืออะไร? OCR จดจำการพิมพ์ด้วยเครื่องที่มีรูปแบบคงที่, ในขณะที่ HTR (Handwritten Text Recognition) ใช้เครือข่ายประสาทเทียมเชิงลึกเพื่อถอดรหัสลายมือมนุษย์ที่ต่อเนื่องและเปลี่ยนแปลงได้พร้อมกับเส้นฐานโค้ง.
Q2. Tesseract OCR สามารถสร้าง PAGE XML หรือผลลัพธ์ ALTO สำหรับเอกสารประวัติศาสตร์ได้หรือไม่? ได้, Tesseract สามารถสร้าง ALTO XML และผลลัพธ์ hOCR แบบดั้งเดิม, และตัวห่อของบุคคลที่สามสามารถแปลงผลลัพธ์เหล่านี้เป็น PAGE XML ได้.
Q3. ทำไมเส้นฐานจึงสำคัญกว่ากล่องขอบเขตในการถอดข้อความลายมือ? เส้นฐานติดตามเส้นธรรมชาติที่โค้งงอของลายมือมนุษย์, ทำให้ซอฟต์แวร์สามารถแยกส่วนตัวอักษรที่ยกขึ้นและลงซ้อนทับที่ชนกันภายในกล่องขอบเขตที่แข็งกรากได้.
Q4. มาตรฐาน IIIF ทำงานร่วมกับรูปแบบไฟล์ OCR เหล่านี้อย่างไร? IIIF ให้บริการภาพความละเอียดสูงผ่าน API เว็บแบบเปิด, ในขณะที่รูปแบบเช่น ALTO หรือ PAGE XML ให้ข้อมูลพิกัดที่สามารถแปลงเป็นคำอธิบายการค้นหาเนื้อหา IIIF ได้.
Q5. รูปแบบไฟล์ใดง่ายที่สุดในการแปลงโดยตรงเป็น PDF ที่สามารถค้นหาได้? ทั้ง hOCR และ ALTO XML สามารถจับคู่กับภาพหน้าต้นฉบับเพื่อสร้างไฟล์ PDF ชั้นคู่ที่สามารถค้นหาได้โดยใช้เครื่องมือเช่น OCRmyPDF.