อัปเดตล่าสุด: 30 ก.ย., 2026
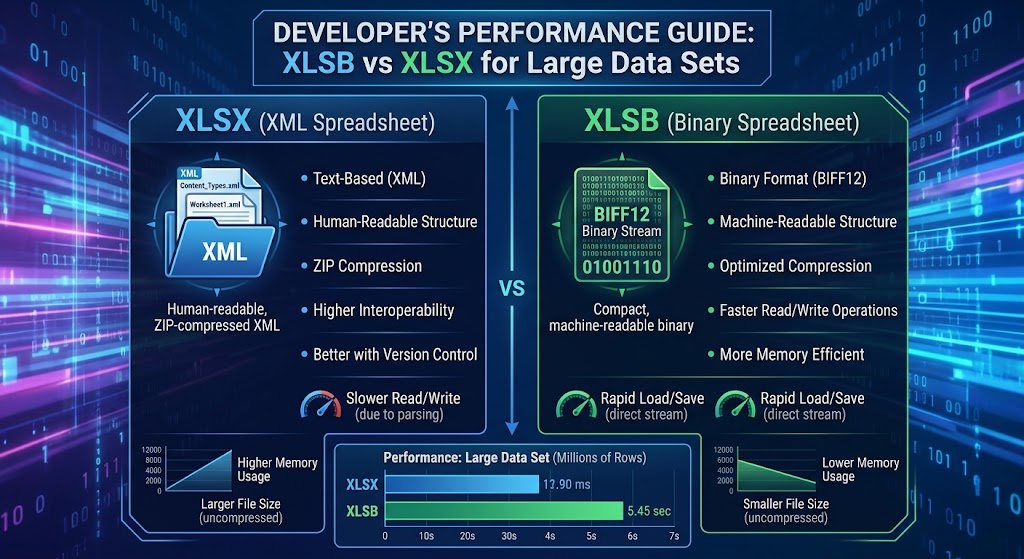
XLSB vs XLSX สำหรับชุดข้อมูลขนาดใหญ่: คู่มือประสิทธิภาพสำหรับนักพัฒนา
หากคุณสร้างสายงานข้อมูล, ระบบรายงานแบ็กเอนด์, หรือเครื่องมือวิเคราะห์ที่เชื่อมต่อกับ Microsoft Excel, คุณอาจเคยเจอ "กำแพง".
ผู้ใช้อัปโหลดสมุดงานที่มี 450,000 แถว เซิร์ฟเวอร์ของคุณสร้างเธรดทำงาน, การใช้หน่วยความจำพุ่งขึ้นเป็นกิกะไบต์, การเก็บกวาดหน่วยความจำทำให้เวลารันหยุดชะงัก, และการดำเนินการของคุณหมดเวลา คุณตรวจสอบข้อมูลที่ส่งมา: เป็นไฟล์ .xlsx มาตรฐาน.
เพื่อแก้ปัญหานี้ นักพัฒนามักใช้เวลาหลายวันในการทำการแบ่งส่วน, ตัวแยกสตรีม, หรือการถ่ายโอนไฟล์ไปยังเวิร์กเกอร์เบื้องหลัง อย่างไรก็ตาม การปรับประสิทธิภาพที่มีประสิทธิผลที่สุดหนึ่งอย่างไม่ต้องออกแบบสถาปัตยกรรมใหม่เลย: การเปลี่ยนส่วนขยายไฟล์จาก .xlsx เป็น .xlsb.
ในคู่มือนี้ เราจะเจาะลึกโครงสร้างของทั้งสองรูปแบบ, ตรวจสอบว่าทำไมสถาปัตยกรรมภายในของพวกมันจึงทำให้ประสิทธิภาพแตกต่างอย่างมาก, เปรียบเทียบผลการทดสอบที่เป็นรูปธรรมระหว่าง Python และ .NET, และสรุปกฎชัดเจนสำหรับการใช้งานสมุดงานไบนารีในสภาพการผลิต.
1. ภายใต้พื้นฐาน: OpenXML เทียบกับ BIFF12
เพื่อทำความเข้าใจว่าทำไมประสิทธิภาพจึงแตกต่างอย่างมากเมื่อจัดการชุดข้อมูลขนาดใหญ่ เราต้องดูว่ารูปแบบแต่ละแบบจัดเก็บบันทึกบนดิสก์อย่างไร.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
ไฟล์ .xlsx และ .xlsb ทั้งสองเป็นคอนเทนเนอร์ ZIP ที่บีบอัดตามมาตรฐาน Open Packaging Conventions (OPC) หากคุณเปลี่ยนชื่อไฟล์ใดไฟล์หนึ่งเป็น .zip แล้วแตกไฟล์ออก คุณจะเห็นโครงสร้างไดเรกทอรีที่คุ้นเคย: _rels, docProps, และ xl/worksheets/.
ความแตกต่างที่สำคัญอยู่ภายในโฟลเดอร์ xl/worksheets/:
- XLSX เก็บแผ่นงานเป็นข้อความ XML ธรรมดา (
sheet1.xml). - XLSB เก็บแผ่นงานเป็นสตรีมไบนารีแบบเฉพาะ (
sheet1.bin), เข้ารหัสโดยใช้ BIFF12 ของ Microsoft (Binary Interchange File Format 12).
วิธีที่ XLSX เข้ารหัสข้อมูล (XML DOM Overhead)
ในแผ่นงาน XLSX แต่ละเซลล์จะถูกประกาศด้วยแท็ก XML อย่างชัดเจน:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
เมื่ออ่านแถวนี้ runtime ของคุณต้อง:
- แตกสตรีม deflate ดิบเป็นข้อความ.
- ทำการแยกโทเคนและพาร์สอักขระสตริงเป็น XML DOM หรือสตรีมเหตุการณ์ SAX.
- ตรวจสอบการเปิดและปิดแท็ก (
<c>,</c>,<v>,</v>). - แก้ไขการค้นหาสตริงจากตาราง
sharedStrings.xmlแยกต่างหาก. - แปลงข้อความ ASCII
"98234.55"ให้เป็นจำนวนจุดลอย IEEE 754 ขนาด 64 บิต.
แต่ละเซลล์จะทำให้เกิดภาระงานของ CPU สำหรับการแยกวิเคราะห์สตริง การจัดสรรสตริง และการวิเคราะห์เชิงไวยากรณ์ หากคูณกับ 500,000 แถวและ 30 คอลัมน์ (รวม 15 ล้านเซลล์) CPU จะใช้ไซเคิลมากกว่าการประมวลผลค่าดูเมนอย่างมหาศาล.
วิธีที่ XLSB เข้ารหัสข้อมูล (BIFF12 Binary Stream)
BIFF12 ยกเลิกการจัดลำดับข้อความโดยสิ้นเชิง แทนการทำเครื่องหมายสตริง ข้อมูลจะถูกจัดเรียงเป็นลำดับต่อเนื่องของบันทึกไบนารีที่มีความยาวเปลี่ยนแปลงได้:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
เซลล์แบบจุดลอยใน BIFF12 ไม่ใช้การแสดงผลเป็นสตริงเช่น "98234.55" แต่จะถูกแทนค่าโดยตรง:
- 2 ไบต์สำหรับ ID ของเรคคอร์ด (เช่น
BrtCellRkหรือBrtCellReal) - 4 ไบต์สำหรับดัชนีคอลัมน์/แถว
- 8 ไบต์ที่มีโครงสร้างไบต์ดับเบิลพรีซิชันแบบ IEEE 754 ดิบ
เมื่อพาร์เซอร์ของคุณอ่านไฟล์ XLSB มันจะข้ามการวิเคราะห์เชิงอักขระโดยสิ้นเชิง มันอ่านส่วนหัวของเรคคอร์ด ดึง 8 ไบต์ดิบจากบัฟเฟอร์ คัดลอกโดยตรงเข้าสู่หน่วยความจำ และเลื่อนตัวชี้ไปข้างหน้า ไม่มีแท็กให้ตรวจสอบ ไม่มีการแปลงประเภทจากสตริงเป็นตัวเลข และไม่มีภาระการถอดรหัส UTF-8 สำหรับข้อมูลเชิงตัวเลขเลย
2. เกณฑ์เชิงปริมาณ: ดิสก์, หน่วยความจำ, และอัตราการส่งผ่าน
เพื่อแสดงผลกระทบในโลกจริง ให้พิจารณาชุดข้อมูลจำลองที่มี 750,000 แถวและ 25 คอลัมน์ (รวมถึงการผสมของไทม์สแตมป์, ตัวเลขแบบจุดลอย, จำนวนเต็ม, และรหัสประเภท)
การทดสอบด้านล่างประเมินข้อมูลตารางที่เหมือนกันซึ่งบันทึกเป็นทั้ง XLSX และ XLSB.
สภาพแวดล้อมการทดสอบ
- CPU: AMD Ryzen 9 5900X (12 คอร์, 24 เธรด)
- RAM: 64 GB DDR4-3600
- ที่เก็บข้อมูล: PCIe 4.0 NVMe SSD
- สภาพแวดล้อมการทำงาน: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
เมตริกประสิทธิภาพหลัก
| เมตริก | XLSX (OpenXML) | XLSB (BIFF12) | การเปลี่ยนแปลง / การปรับปรุง |
|---|---|---|---|
| ขนาดไฟล์บนดิสก์ | 128.4 MB | 68.2 MB | ~47% เล็กลง |
| เวลาในการบันทึก / การทำซีเรียลไลซ์ | 42.6 s | 14.1 s | เร็วกว่า 3.0 เท่า |
| เวลาในการอ่าน (Python DOM parser) | 38.2 s | 8.9 s | เร็วกว่า 4.3 เท่า |
| เวลาอ่าน (Rust/C Engine) | 6.4 s | 1.9 s | เร็วกว่า 3.3 เท่า |
| การจัดสรร Heap สูงสุดระหว่างการอ่าน | ~1.85 GB | ~510 MB | การลดลง ~72% |
ทำไมไฟล์ XLSB ถึงมีขนาดเล็กกว่า
แม้ว่า ทั้งสองรูปแบบจะใช้การบีบอัด ZIP มาตรฐาน แต่สตรีมไบนารีบีบอัดได้อย่างมีประสิทธิภาพมากกว่าข้อความ XML ที่บวม:
- ไวยากรณ์ที่ซ้ำซ้อนถูกกำจัด: XML มีแท็กที่ซ้ำซาก (
<c r="AA1" s="1">) ในแต่ละระเบียน. แม้ว่าการบีบอัด ZIP จะลดผลกระทบของสตริงที่ซ้ำกัน แต่สตรีมข้อมูลที่ไม่ได้บีบอัดยังคงมีขนาดมหาศาล. - ความหนาแน่นของตัวเลข: ใน XML ตัวเลข
12345678.9012ต้องใช้ข้อความ ASCII ขนาด 14 ไบต์. ใน BIFF12 จะถูกเก็บเป็น double ขนาด 8 ไบต์ (หรือบรรจุเป็นระเบียนRKขนาด 4 ไบต์ หากตรงตามกฎความแม่นยำเฉพาะ).
3. การใช้หน่วยความจำและแรงกดดันการเก็บกวาด
สำหรับเว็บเซอร์วิสและไมโครเซอร์วิสที่จัดการคำขอพร้อมกัน ความเร็วของ CPU เป็นเพียงครึ่งหนึ่งของการต่อสู้; การใช้หน่วยความจำ คือจุดที่แอปพลิเคชันจริง ๆ ล้มเหลว.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
เมื่อพาร์เซอร์ XML ประมวลผลไฟล์ XLSX ขนาด 100 MB มันต้องสร้างโทเคนสตริงชั่วคราวหลายพัน, บัฟเฟอร์สไลซ์สตริง, และการค้นหาพจนานุกรม. ในภาษาที่มีการจัดการหน่วยความจำอัตโนมัติ (Java, C#, Go, Node.js, Python) สิ่งนี้ทำให้เกิดการกระจายฮีปอย่างรุนแรงและทำให้รันไทม์ต้องหยุดทำงานบ่อยครั้งเพื่อการเก็บกวาดหน่วยความจำ (GC).
เนื่องจากการแยกวิเคราะห์ XLSB ทำงานโดยตรงบนส่วนของไบต์ที่มีความกว้างคงที่ พาร์เซอร์สามารถอ่านข้อมูลเข้าไปในโครงสร้างที่จัดสรรบนสแตกหรือบัฟเฟอร์ไบต์ที่ใช้ซ้ำได้ ผลลัพธ์คือการใช้หน่วยความจำที่ลดลงอย่างมากและไม่มีการสลับหน่วยจัดสรรเวลาเรียกใช้
4. ตัวอย่างการนำไปใช้โดยนักพัฒนา
มาดูวิธีใช้ประโยชน์จาก XLSB ในสายเครื่องมือของนักพัฒนาที่พบบ่อยกัน
Python: การย้ายจาก OpenPyXL ไปยัง Calamine / PyXLSB
ฟังก์ชันมาตรฐาน pandas.read_excel('data.xlsx') ใช้ค่าเริ่มต้นเป็น openpyxl ซึ่งสร้างโครงสร้างต้นไม้ในหน่วยความจำที่หนัก
เพื่อประมวลผลไฟล์ XLSB ขนาดใหญ่ด้วยความเร็วสูงสุด ให้ใช้เอนจิน calamine ที่ขับเคลื่อนด้วย Rust (สามารถใช้ได้ผ่าน python-calamine และรวมเข้ากับ Pandas รุ่นใหม่):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
หากคุณกำลังวนซ้ำชุดข้อมูลขนาดมหาศาลแบบแถวต่อแถวโดยไม่โหลดเมทริกซ์ทั้งหมดเข้าสู่ DataFrame, pyxlsb ให้ตัววนซ้ำสตรีมมิ่งที่มีน้ำหนักเบา:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: การรับข้อมูลสตรีมประสิทธิภาพสูง
ใน .NET ไลบรารีเช่น ClosedXML หรือ EPPlus เหมาะสำหรับการสร้างไฟล์มาตรฐาน, แต่สำหรับการอ่านไฟล์ขนาดใหญ่โดยไม่ทำให้หน่วยความจำหมด, ExcelDataReader ที่รองรับ XLSB มีความเร็วเป็นพิเศษ:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. การพิจารณาเชิงสถาปัตยกรรม: เมื่อไม่ควรใช้ XLSB
แม้จะมีข้อได้เปรียบด้านประสิทธิภาพที่เหนือชั้น, XLSB ก็ไม่ได้เป็นวิธีแก้ปัญหาทั้งหมด คุณควรพิจารณาข้อแลกเปลี่ยนด้านการดำเนินงานหลายประการก่อนที่จะบังคับใช้ในสแต็กของคุณ:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. ระบบนิเวศและการสนับสนุนไลบรารี
- XLSX: สากล. แทบทุกภาษา, ไลบรารี, เครื่องมือ SaaS (Google Sheets, Airtable, Tableau) และตัวแยกวิเคราะห์เว็บสนับสนุน OpenXML โดยเนทีฟ.
- XLSB: น้อยกว่าสากล. แม้ว่า Excel, LibreOffice, และไลบรารีนักพัฒนาที่เจริญ (
ExcelDataReader,pyxlsb,calamine,Aspose) จะสนับสนุน, แต่หลายแพ็คเกจที่เบา หรือตัวแยกวิเคราะห์ JavaScript บนเว็บแบบบริสุทธิ์ (เช่นเวอร์ชันเก่าของSheetJS) มีการสนับสนุนที่จำกัดหรืออ่านอย่างเดียว.
2. การเปรียบเทียบใน Git & ระบบควบคุมเวอร์ชัน
- XLSX: เนื่องจากมันมี XML ข้อความอยู่ภายในคอนเทนเนอร์ ZIP, เครื่องมือบรรทัดคำสั่งและ Git hooks สามารถแตกไฟล์และจัดรูปแบบ XML เพื่อสร้างความแตกต่างเชิงโครงสร้างที่อ่านได้ระหว่างคอมมิต.
- XLSB: ข้อมูลไบนารีบริสุทธิ์. ระบบควบคุมเวอร์ชันจะถือว่าเป็นบล็อบไบนารีที่ไม่เปิดเผย, ทำให้ไม่มีความเป็นไปได้ในการเปรียบเทียบแบบละเอียดหรือการรวมระดับบรรทัด.
3. การแสดงผลบนเว็บไคลเอนต์
หากสถาปัตยกรรมของคุณพึ่งพาการแสดงสเปรดชีตโดยตรงในเบราว์เซอร์ผ่าน WebAssembly หรือ JavaScript ฝั่งไคลเอนต์, ตัวแยกวิเคราะห์ XLSX จะมีความสมบูรณ์กว่าอย่างมากและมีโอกาสเกิดบั๊กการแสดงผลกรณีขอบน้อยกว่าตัวแยกวิเคราะห์ไบนารีฝั่งไคลเอนต์.
4. กระบวนการรับข้อมูลจากบุคคลที่สาม
หากคุณกำลังส่งออกไฟล์ให้กับลูกค้าองค์กรภายนอก นโยบายความปลอดภัยขององค์กรที่เข้มงวดหลายแห่งจะทำเครื่องหมายไฟล์ .xlsb เนื่องจากไฟล์ BIFF12 สามารถเก็บมาโคร VBA ได้เช่นเดียวกับไฟล์ .xlsm (โดยไม่ต้องใช้ส่วนขยายแยก) ตัวกรองอีเมลและสแกนเนอร์ไฟร์วอลล์บางตัวจึงแยกไฟล์อัปโหลด .xlsb ออกเป็นภัยคุกคามที่อาจมีมาโคร
6. สรุปการเปรียบเทียบ: ฟอร์แมตใดชนะ?
| คุณลักษณะ | XLSX | XLSB | ผู้ชนะ |
|---|---|---|---|
| ความเร็วในการอ่าน / แยกวิเคราะห์ | ปานกลางถึงแย่ | เร็วเป็นพิเศษ | XLSB |
| ความเร็วในการเขียน / สร้าง | ใช้ CPU อย่างหนัก | เร็ว | XLSB |
| การบีบอัดไฟล์ | ดี | ยอดเยี่ยม (~40-50% smaller) | XLSB |
| การจัดสรรหน่วยความจำ | สูง (แรงกดดัน GC สูง) | ต่ำ (การอ่านไบต์โดยตรง) | XLSB |
| ความสามารถในการทำงานร่วมกันของเครื่องมือ | สากล | สูง แต่เลือกสรร | XLSX |
| ความลำบากในการสแกนความปลอดภัย | น้อยที่สุด | ผลบวกเท็จเป็นครั้งคราว | XLSX |
| ความสามารถของมาโคร | ไม่มี (.xlsm จำเป็น) | ใช่ (รองรับมาโครโดยเนทีฟ) | ผูก |
7. คำตัดสินของนักพัฒนา
ใช้ XLSX เมื่อ:
- ไฟล์มีขนาดเล็กถึงปานกลาง (< 50,000 แถว).
- ไฟล์ของคุณต้องถูกนำเข้าโดยแพลตฟอร์ม SaaS ของบุคคลที่สามหรือแอปพลิเคชันผู้บริโภค (เช่น Google Sheets).
- คุณไม่สามารถควบคุมสภาพแวดล้อมของลูกค้าสุดท้ายที่อ่านไฟล์ได้.
สลับเป็น XLSB เมื่อ:
- คุณกำลังสร้าง pipeline ภายใน งานแบบ batch, ระบบ ETL หรืองานของ worker ที่จัดการการสกัดข้อมูลขนาดใหญ่ (> 100,000 แถว).
- เซิร์ฟเวอร์ของคุณกำลังเจอข้อผิดพลาด out-of-memory (OOM) ระหว่างการทำ serialization หรือ deserialization ของสเปรดชีต
- คุณต้องลดขนาดการใช้พื้นที่จัดเก็บ S3/blob และเวลาเครือข่ายสำหรับโมเดลการเงินที่ทำซ้ำบ่อยหรือการส่งออกข้อมูลขนาดใหญ่ให้เหลือน้อยที่สุด
การเปลี่ยนไปใช้ XLSB มักจะง่ายเพียงแค่เปลี่ยนสตริงการกำหนดค่าในบริการส่งออกของคุณ แต่ก็ให้ผลลัพธ์การเพิ่มประสิทธิภาพการทำงานถึง 3‑5 เท่าซึ่งโดยปกติจะต้องใช้เวลาหลายสัปดาห์ในการปรับโค้ดให้ได้ผลเช่นนั้น
คำถามที่พบบ่อย (FAQ)
**Q1: ไฟล์ XLSB รองรับขีดจำกัดแถวและคอลัมน์เดียวกันกับไฟล์ XLSX หรือไม่? ใช่; ทั้ง XLSB และ XLSX มีขีดจำกัดกริดเดียวกันคือ 1,048,576 แถวโดย 16,384 คอลัมน์ต่อเวิร์กชีต
**Q2: ไฟล์ XLSB สามารถเก็บแมโคร VBA ได้อย่างปลอดภัยโดยไม่ต้องเปลี่ยนส่วนขยายของไฟล์หรือไม่?
ใช่, แตกต่างจาก XLSX (ซึ่งต้องบันทึกเป็น XLSM เพื่อให้โค้ดทำงาน), XLSB รองรับการจัดเก็บแมโคร VBA แบบไบนารีโดยตรงภายในรูปแบบไฟล์ .xlsb เดียวกัน
**Q3: ทำไมการบันทึกไฟล์เป็น XLSB จึงทำให้ขนาดไฟล์ลดลง หากทั้งสองรูปแบบถูกบีบอัดด้วย ZIP อยู่แล้ว? XLSB กำจัดแท็กการทำเครื่องหมายข้อความที่ยาวเกินไปและเข้ารหัสตำแหน่งเซลล์, บันทึก, และค่าตัวเลขดิบเป็นสตรีมไบต์ไบนารีที่กระชับซึ่งบีบอัดอย่างหนาแน่นกว่าข้อความ XML ธรรมดาอย่างมาก
**Q4: Google Sheets สามารถนำเข้าและแก้ไขไฟล์ XLSB ได้โดยตรงหรือไม่?
ไม่; Google Sheets ไม่สามารถเปิดหรือแปลงไฟล์ .xlsb ได้โดยตรง, จำเป็นต้องแปลงเป็น .xlsx หรือ CSV ก่อนนำเข้า
**Q5: ไฟล์ XLSB มีแนวโน้มที่จะเกิดการเสียหายของข้อมูลมากกว่าไฟล์ XLSX หรือไม่? ในขณะที่ไฟล์ XML บางครั้งสามารถตรวจสอบหรือซ่อมแซมด้วยตนเองโดยใช้โปรแกรมแก้ไขข้อความเมื่อมีการเสียหายบางส่วน, สตรีมไบนารี BIFF12 ต้องการการจัดตำแหน่งไบต์ที่เข้มงวดและยากต่อการกู้คืนด้วยตนเองหากส่วนโครงสร้างเสียหาย