Son Güncelleme: 20 Aug, 2026
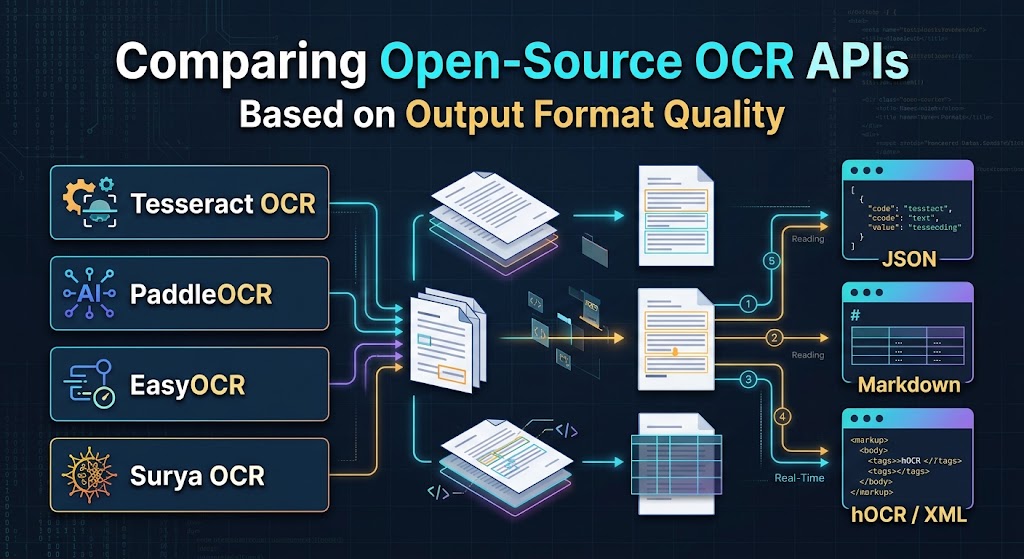
Açık Kaynak OCR API’lerini Çıktı Formatı Kalitesine Göre Karşılaştırma
Mühendisler Optik Karakter Tanıma (OCR) motorlarını değerlendirirken, karakter hata oranı (CER) ve kelime hata oranı (WER) genellikle ölçütlerin çoğunu oluşturur. Tanıma doğruluğu önemli olsa da, üretimde sorunun sadece yarısını çözer.
Karmaşık çok sütunlu PDF’leri ayrıştırıyorsanız, makbuzlardan satır öğelerini çıkarıyorsanız veya teknik raporları bir LLM gömme hattına alıyorsanız, ham metin dökümleri büyük mühendislik yükü oluşturur. Düzen farkındalığı, mantıksal okuma sırası veya koordinat verisi olmayan bir karakter dizisi, ekibinizi kırılgan sezgisel ayrıştırıcılar yazmaya zorlar.
Modern belge iş akışları için gerçek ayırıcı çıktı formatı kalitesi‘dir: bir motorun koordinatları, okuma sırasını, yapısal hiyerarşiyi ve tablo verilerini ne kadar tutarlı ve temiz bir şekilde sunduğu.
Aşağıda, dört önde gelen açık kaynak OCR motorunun—Tesseract, PaddleOCR, EasyOCR ve Surya OCR—mühendislik odaklı bir karşılaştırması yer alıyor; çıktılarının otomatik hatlar içinde nasıl davrandığı değerlendiriliyor.
Ortak Çıktı Formatları: Mühendislerin Gerçekten İhtiyacı Olanlar
Her OCR API’si algılanan metni farklı paketler. Bu formatları anlamak, boru hattınızın ne kadar son işlem gerektirdiğini belirlemenize yardımcı olur:
- Düz Metin (
.txt): En basit temsil. Tüm konumsal meta verileri kaldırır ve çok sütunlu düzenleri yatay okumalara çevirir, bu da paragrafları karıştırabilir. - Arşiv Standartları (
hOCR,ALTO XML): Kütüphane arşivlemesinde standart olan XML/HTML tabanlı formatlar. Koordinatları, yazı tipi tahminlerini ve güven puanlarını DOM düğümlerine gömerler. Belge yeniden yapılandırma için son derece sağlam, ancak mikro hizmetler için hantal. - Yapılandırılmış JSON: Modern web arka uçları için varsayılan seçim. Koordinat dizileri (sınırlayıcı kutular veya çokgenler), güven puanları ve hiyerarşik blok/ satır/ kelime yapıları sağlar.
- Markdown (
.md) / HTML Tabloları: Retrieval-Augmented Generation (RAG) için modern standart. Semantik bölümleri (başlıklar, listeler, kalın metin) ve tablo matrislerini, aşağı akışta mekansal yeniden yapılandırma gerektirmeden korur.
1. Tesseract OCR
Google tarafından sürdürülen Tesseract, açık kaynak OCR’nin temel iş gücü olmaya devam ediyor. Mimarisi, LSTM tabanlı bir karakter motoru ile desteklenen geleneksel sayfa segmentasyon algoritmalarına büyük ölçüde dayanır.
Yerel Çıktı Formatları
- Birincil Çıktılar: Düz metin, hOCR (HTML), ALTO XML, TSV (Sekme Ayrılmış Değerler) ve aranabilir PDF/A.
- Düzen Farkındalığı: Kural tabanlı sezgisel yöntemler Sayfa Bölütleme Modları (PSM) aracılığıyla.
Çıktı Formatı Analizi
- Nerede Üstünlük Sağlar: Tesseract’in
TSVvehOCRdışa aktarımları standartlaştırılmış ve öngörülebilir. Tek bir TSV dışa aktarımı,level,page_num,block_num,par_num,line_num,word_num,left,top,width,heightveconfiçin yapılandırılmış sütunlar döndürür. Kağıt arşivlerini aranabilir PDF’lere dönüştürüyorsanız ya da kurumsal standartlara sıkı uyum gerektiriyorsa, Tesseract bunu özel bağlayıcı kodu olmadan yerel olarak yönetir. - Nerede Eksik Kalır: Tesseract’in yerel bir JSON API’si yoktur. Çıktısını Python veya Node.js’te kullanmak, XML/TSV dosyalarını ayrıştırmayı veya
pytesseractgibi sarmalayıcıları kullanmayı gerektirir. Düzen motoru ayrıca standart dışı sütun akışıyla mücadele eder, manuel sınırlama kırpma işlemleri sağlanmadıkça yan yana sütunlardan gelen metinleri sık sık karıştırır.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Baidu’nun PaddlePaddle çerçevesi tarafından desteklenen PaddleOCR, hafif modelleri, kapsamlı çok‑dilli desteği ve özel belge analiz araç takımı (PP-Structure) sayesinde geniş çapta benimsenmiştir.
Yerel Çıktı Formatları
- Ana Çıktılar: Python listeleri/sözlükleri, ham JSON, görselleştirme katmanları ve PP-Structure aracılığıyla yapılandırılmış HTML.
- Düzen Farkındalığı: Yüksek (düzen ayrıştırması, yön sınıflandırması ve tablo kurtarma için derin öğrenme modelleri kullanılarak).
Çıktı Formatı Analizi
- Nerede Üstün Performans Gösterir: Standart PaddleOCR, metin dizgileri ve güven skorlarıyla birlikte 4 noktalı çokgen koordinatlarını (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) döndürür. Bu, eğik veya eğrileşmiş metinleri sorunsuz bir şekilde işler. Ancak, gerçek gücü PP-Structure paketinde yatmaktadır; bu paket, düzen bölgelerini (başlık, metin, tablo, şekil) algılar ve tabloları doğrudan geçerli HTML dizgilerine (<table>...</table>) ayrıştırır. Bu, sınırlayıcı kutulardan hücre kapsamlarını manuel olarak hesaplama ihtiyacını ortadan kaldırır. - Nerede Eksik Kalır: Temel API, farklı sürümlerde standart özellik anahtarlarından yoksun iç içe diziler döndürür. Yapılandırılmış uygulamalar için geliştiriciler genellikle alan adlarını (
bbox,text,confidence) standartlaştıran bir ara adaptör yazarlar.
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
JaidedAI tarafından PyTorch üzerine inşa edilen EasyOCR, hızlı geliştirici benimsemesi için tasarlanmıştır. CRAFT (Character Region Awareness for Text Detection) ve derin öğrenme tanıma ağlarını minimal bir API içinde paketler.
Yerel Çıktı Formatları
- Ana Çıktılar: Koordinat çiftleri, tanınan dizeler ve güven değerleri içeren Python listeleri.
- Düzen Farkındalığı: Düşük ila orta (yalnızca metin satırı algılama; belge düzeyinde yapısal ayrıştırma yok).
Çıktı Formatı Analizi
- Nerede Üstün: Dönüş nesnesinin basitliği eşsizdir:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Bu çıktıyı standart bir REST yanıtına eşlemek ya da doğrudan GeoJSON/özel şemalara serileştirmek sadece birkaç satır kod gerektirir. Doğal sahne metinleri, plaka ve izole belge kırpımları üzerinde güvenilir bir şekilde çalışır.
- Nerede Eksik: EasyOCR bütünsel belge düzeni analizini gerçekleştirmez. Tabloları, başlık hiyerarşilerini veya karmaşık sütunlar arasındaki okuma sıralarını tanımlamaz. EasyOCR’ı iki sütunlu bir akademik makalede kullanmak, üst akışta bir düzen algılama modeli (örneğin YOLO veya LayoutLM) ile eşleştirilmediği sürece, sık sık iç içe geçmiş metin parçacıkları üretir.
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya modern bir derin öğrenme OCR çerçevesidir ve özellikle karmaşık belge anlama ve LLM veri alım hatları için tasarlanmıştır.
Yerel Çıktı Formatları
- Ana Çıktılar: Pydantic-modeli JSON yapıları, mantıksal okuma sırası indeksleri, düzen sınırlama bölgeleri ve satır algılama çokgenleri.
- Layout Awareness: Son derece yüksek (derin öğrenmeye dayalı düzen analizi ve okuma sırası sıralaması).
Çıktı Formatı Analizi
- Where It Excels: Surya, modern AI mühendisliğinin zorluklarını doğrudan ele alır. Belgelerin üstten alta, soldan sağa okunduğu varsayımının yerine, Surya okuma sırasını tahmin etmek için özel bir model kullanır. Satırları mantıksal anlamsal bloklara gruplar, çok sütunlu genişlemeleri doğal olarak yönetir ve Pydantic aracılığıyla tiplenmiş yapılar üretir. Bu, vektör veritabanlarına ve Markdown dönüştürücülere sonraki aşama veri alımını doğrudan ve güvenilir kılar.
- Where It Falls Short: Daha yeni ve daha ağır bir PyTorch tabanlı çerçeve olarak, Surya, Tesseract gibi optimize edilmiş C++ motorları veya kuantize edilmiş Paddle modelleri gibi yüksek verimliliği eşleştirmek için özel GPU hesaplaması gerektirir. hOCR veya ALTO gibi eski arşiv standartlarını hedef almaz.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Yüz Yüze Karşılaştırma Matrisi
| Yetenek / Biçim | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Yerel hOCR / ALTO XML | Yerel destek | Yalnızca üçüncü taraf | Yok | Yok |
| Sınır Kutusu Geometrisi | Eksen hizalı (x, y, w, h) | 4 noktalı çokgen | 4 noktalı çokgen | Poligon + Düzen blokları |
| Tablo Ayrıştırma | Yalnızca Koordinat TSV | HTML tablo dizgileri | Yok | Hücre koordinat ızgaraları |
| Okuma Sırası Algılama | Kural tabanlı (çok sütunlu kırılır) | ML düzen analizi | Temel satır gruplama | Özel okuma sırası modeli |
| Doğrudan JSON Şemaları | Dönüştürme gerektirir | Python Sözlüğü / JSON | Python Listesi / JSON | Tiplenmiş Pydantic Modelleri |
| İdeal Aşağı Akış Hedefi | Arşiv PDF’leri, Eski DMS | Form/Fiş Verileri, ERP’ler | Hızlı Betikler, Sahne Metni | LLM Alımı, RAG Mimarileri |
İş Akışı Önerileri: Hangisini Seçmelisiniz?
- Tesseract’ı Seçin eğer uyumluluk gereksinimleriniz hükümet veya arşiv kayıtları için standartlaştırılmış
hOCR,ALTO XMLveya aranabilir PDF/A teslimatları talep ediyorsa. - PaddleOCR’ı Seçin eğer operasyonel finansal belgeleri (faturalar, fişler, vergi formları) işliyorsanız ve karmaşık, kenarsız tabloları HTML veya elektronik tablolara dönüştürmeniz gerekiyorsa.
- EasyOCR’ı Seçin eğer doğal görüntüler, sokak işaretleri veya kırpılmış UI öğelerinden metin algılamak ve çıkarmak için hafif, Pythonik bir kütüphaneye, konfigürasyon zahmeti olmadan ihtiyacınız varsa.
- Surya OCR’ı Seçin eğer yapılandırılmamış iş raporları, araştırma makaleleri ve teknik kılavuzları, mantıksal okuma sırası ve temiz yapısal sınırların hayati olduğu bir LLM veya vektör arama motoruna besliyorsanız.
Sıkça Sorulan Sorular (SSS)
1. Hangi açık kaynaklı OCR çıktı formatı, Büyük Dil Modellerine beslemek için en kolaydır?
Surya OCR’un okuma sırasına duyarlı JSON’u ve PaddleOCR PP-Structure’ın HTML tabloları, LLM istem bağlamları ve RAG indekslemesi için en temiz temsilleri sağlar.
2. Tesseract, üçüncü taraf araçlar olmadan yerel olarak JSON yanıtları üretebilir mi?
Hayır, Tesseract yerel olarak metin, TSV, PDF ve hOCR/ALTO XML çıktısı verir; JSON üretmek, TSV veya hOCR çıktısını ara bir ayrıştırıcı kullanarak dönüştürmeyi gerektirir.
3. 4 noktalı çokgen koordinatları, eksen hizalı sınırlayıcı kutulardan nasıl farklıdır?
Eksen hizalı kutular, düz metin varsayımıyla [x, y, width, height] kullanır, 4 noktalı çokgenler ise döndürülmüş, eğik veya kıvrımlı metin satırlarını doğru bir şekilde çevrelemek için dört koordinat çifti sağlar.
4. Hangi motor, gevşek koordinatlar yerine tablo yapılarını doğrudan koda çıktılar?
PaddleOCR’nin PP-Structure modülü, tespit edilen tablo sınırlarını tam HTML tablo etiketlerine (<table>, <tr>, <td>) yeniden oluşturur ve özel uzamsal matematikten kaçınır.
5. Standart EasyOCR çıktısı çok sütunlu bilimsel makalelerde neden zorlanıyor?
EasyOCR, metin satırlarını küresel düzen hiyerarşisi yerine yerel yakınlığa göre tanımlar; bu, dış bir düzen motoru tarafından sınırlanmadıkça yan yana sütunlardaki metinlerin birbirine karışmasına neden olur.