Son Güncelleme: 30 Eyl, 2026
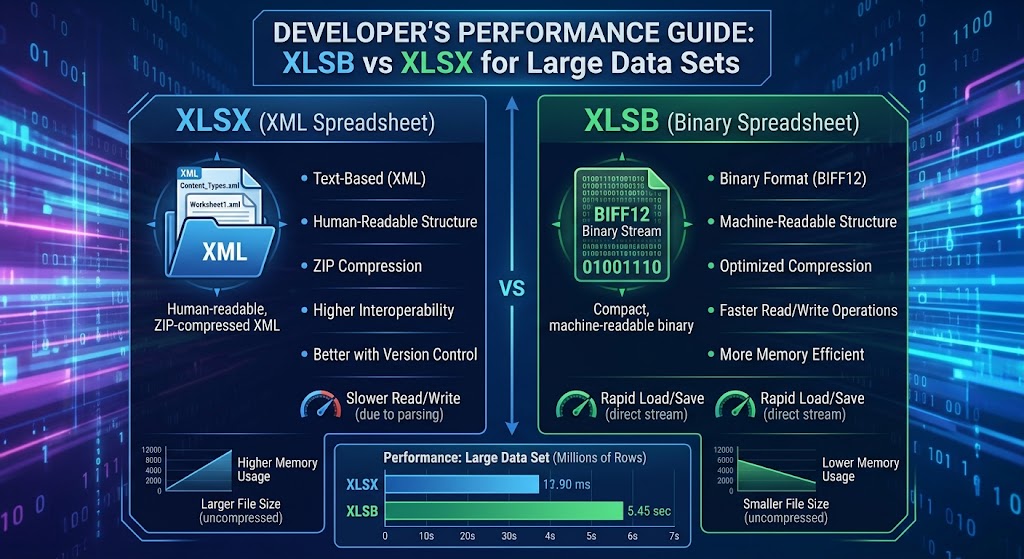
Büyük Veri Setleri için XLSB vs XLSX: Geliştiricinin Performans Rehberi
Microsoft Excel ile etkileşen veri hatları, backend raporlama motorları veya analiz araçları oluşturuyorsanız, muhtemelen “duvara çarpmış” olabilirsiniz.
Bir kullanıcı 450.000 satırlı bir çalışma kitabı yüklüyor. Sunucunuz çalışan iş parçacıkları oluşturuyor, bellek tüketimi gigabaytlara çıkıyor, çöp toplama çalışma zamanını donduruyor ve yürütmeniz zaman aşımına uğruyor. Yükü inceliyorsunuz: bu standart bir .xlsx dosyası.
Bunu çözmek için geliştiriciler genellikle parçalama, akış ayrıştırıcıları uygulamak veya dosyaları arka plan çalışanlarına devretmek için günler harcar. Ancak, en etkili iyileştirmelerden biri hiçbir mimari yeniden tasarım gerektirmez: dosya uzantısını .xlsx‘den .xlsb‘ye değiştirmek.
Bu rehberde, her iki formatın iç yapısına derinlemesine bakıyor, iç mimarilerinin neden köklü şekilde farklı performans özellikleri ürettiğini inceliyor, Python ve .NET üzerindeki somut benchmarkları karşılaştırıyor ve üretimde ikili çalışma kitaplarını ne zaman dağıtmanız gerektiğine dair net kurallar ortaya koyuyor.
1. Altında Neler Oluyor: OpenXML vs. BIFF12
Performansın büyük veri setlerinde neden bu kadar dramatik bir şekilde farklılaştığını anlamak için, her bir formatın kayıtları diskte nasıl sakladığına bakmalıyız.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Hem .xlsx hem de .xlsb dosyaları, Açık Paketleme Kurallarına (OPC) uygun sıkıştırılmış ZIP konteynerleridir. Bu dosyalardan birinin adını .zip olarak değiştirip çıkartırsanız, tanıdık bir dizin yapısı göreceksiniz: _rels, docProps ve xl/worksheets/.
xl/worksheets/ klasörünün içinde kritik fark bulunur:
- XLSX, sayfaları düz XML metni (
sheet1.xml) olarak depolar. - XLSB, sayfaları özel ikili akışlar (
sheet1.bin) olarak depolar; bu akışlar Microsoft’un BIFF12 (Binary Interchange File Format 12) formatıyla kodlanmıştır.
Nasıl XLSX Veri Kodlar (XML DOM Overhead)
Bir XLSX çalışma sayfasında, her hücre açık XML etiketleriyle tanımlanır:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Bu satırı okurken, çalışma zamanınız şunları yapmalıdır:
- Ham deflate akışını metne sıkıştırmayı açın.
- Dize karakterlerini token’lara ayırın ve bir XML DOM ya da SAX olay akışına ayrıştırın.
- Açma ve kapama etiketlerini doğrulayın (
<c>,</c>,<v>,</v>). - Ayrı bir
sharedStrings.xmltablosundan dize aramalarını çözün. - ASCII metni
"98234.55"bir IEEE 754 64-bit kayan nokta sayısına ayrıştırın.
Her bir hücre, dize ayrıştırması, dize tahsisi ve leksikal analiz için CPU yükü oluşturur. Bunu 500.000 satır ve 30 sütun (15 milyon hücre) boyunca çarparsak, CPU, alan değerlerini işlemekten çok sözdizimini ayrıştırmak için çok daha fazla çevrim harcar.
Nasıl XLSB Veri Kodlar (BIFF12 Binary Stream)
BIFF12, metin serileştirmesini tamamen ortadan kaldırır. Dize işaretlemesi yerine, veri değişken uzunlukta ikili kayıtların sıralı bir dizisi olarak düzenlenir:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12’de kayan noktalı bir hücre, "98234.55" gibi dize temsillerini kullanmaz. Doğrudan temsil edilir:
- Kayıt kimliği için 2 bayt (ör.
BrtCellRkveyaBrtCellReal) - Sütun/satır indeksleri için 4 bayt
- Ham, IEEE 754 çift duyarlıklı bayt yapısını içeren 8 bayt
Parser’ınız bir XLSB dosyasını okuduğunda, sözcüksel ayrıştırmayı tamamen atlar. Kayıt başlığını okur, tampondan 8 ham baytı alır, doğrudan belleğe kopyalar ve işaretçiyi ileri hareket ettirir. Doğrulanacak etiket yoktur, dizeden sayıya tip dönüşümü yoktur ve sayısal veriler için sıfır UTF-8 kod çözme yükü vardır.
2. Nicel Kıyaslamalar: Disk, Bellek ve İşlem Hızı
Gerçek dünya etkisini göstermek için, 750,000 satır ve 25 sütun içeren simüle edilmiş bir veri kümesini düşünün (zaman damgaları, kayan nokta sayıları, tam sayılar ve kategori kodlarının bir karışımı).
Aşağıdaki testler, aynı tablo verisinin hem XLSX hem de XLSB olarak kaydedilmiş halini değerlendirir.
Test Ortamı
- CPU: AMD Ryzen 9 5900X (12 çekirdek, 24 iş parçacığı)
- RAM: 64 GB DDR4-3600
- Depolama: PCIe 4.0 NVMe SSD
- Çalışma Zamanı: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Ana Performans Ölçütleri
| Metrik | XLSX (OpenXML) | XLSB (BIFF12) | Delta / İyileştirme |
|---|---|---|---|
| Diskteki Dosya Boyutu | 128.4 MB | 68.2 MB | ~%47 daha küçük |
| Kaydetme / Serileştirme Süresi | 42.6 s | 14.1 s | 3.0x daha hızlı |
| Okuma Süresi (Python DOM ayrıştırıcı) | 38.2 s | 8.9 s | 4.3x daha hızlı |
| Okuma Süresi (Rust/C Motoru) | 6.4 s | 1.9 s | 3.3x daha hızlı |
| Okuma sırasında En Yüksek Yığın Tahsisi | ~1.85 GB | ~510 MB | ~72% azalma |
Neden XLSB Dosyaları Daha Küçük
Her iki format da standart ZIP sıkıştırması kullansa da, ikili akışlar şişirilmiş XML metninden çok daha verimli sıkıştırma yapar:
- Gereksiz sözdizimi ortadan kaldırılır: XML, her bir kayıtta tekrarlayan etiketler (
<c r="AA1" s="1">) içerir. ZIP sıkıştırması tekrarlanan dizeleri azaltırken, sıkıştırılmamış veri akışı devasa boyuttadır. - Sayısal yoğunluk: XML’de,
12345678.9012sayısı 14 bayt ASCII metni gerektirir. BIFF12’de ise bu, 8 baytlık bir double olarak (veya belirli hassasiyet kurallarına uyuyorsa 4 baytlıkRKkaydı olarak) paketlenir.
3. Bellek Ayak İzi ve Çöp Toplama Baskısı
Eşzamanlı istekleri yöneten web servisleri ve mikroservisler için CPU hızı sadece mücadelenin yarısıdır; bellek ayak izi uygulamaların gerçekten başarısız olduğu yerdir.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Bir XML ayrıştırıcısı 100 MB’lık bir XLSX dosyasını işlediğinde, binlerce geçici dize belirteci, dize dilim tamponu ve sözlük araması oluşturmak zorundadır. Çöp toplayıcı dilli dillerde (Java, C#, Go, Node.js, Python), bu aşırı yığın parçalanmasına neden olur ve çalışma zamanını sık sık Çöp Toplama (GC) duraklamalarına zorlar.
XLSB ayrıştırması doğrudan sabit genişlikte bayt dilimlerinde çalıştığı için ayrıştırıcılar verileri yığıt tahsisli yapılara veya yeniden kullanılabilir bayt tamponlarına okuyabilir. Sonuç, bellek ayak izinin büyük ölçüde azalması ve çalışma zamanı tahsiscisinin hiç zorlanmamasıdır.
4. Geliştirici Uygulama Örnekleri
XLSB’yi yaygın geliştirici araç zincirlerinde nasıl kullanabileceğimize bir göz atalım.
Python: OpenPyXL’den Calamine / PyXLSB’ye Geçiş
Standart pandas.read_excel('data.xlsx') varsayılan olarak openpyxl‘i kullanır; bu da ağır bir bellek içi ağaç oluşturur.
Büyük XLSB dosyalarını en yüksek hızla işlemek için Rust destekli calamine motorunu kullanın (python-calamine aracılığıyla kullanılabilir ve modern Pandas’a entegre edilmiştir):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Eğer tüm matrisi bir DataFrame’e yüklemeden, büyük veri kümelerini satır satır döngüyle işliyorsanız, pyxlsb hafif bir akış yineleyicisi sunar:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Yüksek Performanslı Akış Alımı
.NET’te ClosedXML veya EPPlus gibi kütüphaneler standart oluşturma için harikadır, ancak büyük dosyaları bellek tükenmeden almak için XLSB desteğine sahip ExcelDataReader son derece hızlıdır:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Mimari Tavizler: XLSB’yi KULLANMAMANIZ GEREKEN Durumlar
Büyük performans avantajlarına rağmen, XLSB sihirli bir çözüm değildir. Yığınızda uygulamaya koymadan önce birkaç operasyonel ödünç almayı (takas) değerlendirmelisiniz:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Ekosistem ve Kütüphane Desteği
- XLSX: Evrensel. Neredeyse her dil, kütüphane, SaaS aracı (Google Sheets, Airtable, Tableau) ve web ayrıştırıcısı OpenXML’i yerel olarak destekler.
- XLSB: Daha az yaygın. Excel, LibreOffice ve olgun geliştirici kütüphaneleri (
ExcelDataReader,pyxlsb,calamine,Aspose) desteklerken, birçok hafif paket veya saf web tabanlı JavaScript ayrıştırıcısı (örneğinSheetJS‘in eski sürümleri) sınırlı veya yalnızca okuma desteğine sahiptir.
2. Git ve Sürüm Kontrolü Fark Analizi
- XLSX: ZIP konteyneri içinde metin XML’i barındırdığı için, komut satırı araçları ve Git kancaları XML’i açıp biçimlendirerek commit’ler arasındaki okunabilir yapısal farkları oluşturabilir.
- XLSB: Saf ikili veri. Sürüm kontrol sistemleri onu tamamen opak bir ikili blob olarak ele alır, bu da ayrıntılı farklaştırma veya satır düzeyinde birleştirme olasılığını ortadan kaldırır.
3. Web İstemci İşleme
Mimariniz tarayıcıda WebAssembly veya istemci tarafı JavaScript aracılığıyla elektronik tabloları doğrudan render etmeye dayanıyorsa, XLSX ayrıştırıcıları istemci tarafı ikili ayrıştırıcılara göre çok daha olgun ve uç durum render hatalarına daha az eğilimlidir.
4. Üçüncü Taraf Alım Boru Hatları
Dış kurumsal müşterilere dosya dışa aktarımı yapıyorsanız, birçok katı kurumsal güvenlik politikası .xlsb dosyalarını işaretler. BIFF12 dosyaları, .xlsm dosyalarına benzer şekilde VBA makrolarını ayrı bir uzantı gerektirmeden depolayabildiği için, bazı e-posta filtreleri ve güvenlik duvarı tarayıcıları .xlsb yüklemelerini potansiyel makro içeren tehditler olarak karantinaya alır.
6. Özet Karşılaştırma: Hangi Format Kazanıyor?
| Özellik | XLSX | XLSB | Kazanan |
|---|---|---|---|
| Okuma / Ayrıştırma Hızı | Orta ila Kötü | Ateş gibi Hızlı | XLSB |
| Yazma / Oluşturma Hızı | CPU Yoğun | Hızlı | XLSB |
| Dosya Sıkıştırma | İyi | Mükemmel (~%40-50 daha küçük) | XLSB |
| Bellek Tahsisi | Yüksek (Yoğun GC baskısı) | Düşük (Doğrudan bayt okuma) | XLSB |
| Araç Uyumluluğu | Evrensel | Yüksek, ancak seçici | XLSX |
| Güvenlik Tarama Sürtünmesi | Minimum | Ara sıra yanlış pozitifler | XLSX |
| Makro Yeteneği | Hayır (.xlsm gerekli) | Evet (Makroları yerel olarak destekler) | Bağla |
7. Geliştiricinin Kararı
Şu durumlarda XLSX kullanın:
- Dosyalar küçük ila orta boyutta (< 50,000 satır).
- Dosyalarınız üçüncü taraf SaaS platformları veya tüketici uygulamaları (ör. Google Sheets) tarafından alınmalıdır.
- Dosyayı okuyan son müşterinin ortamını kontrol edemezsiniz.
Şu durumlarda XLSB‘ye geçin:
- İç pipeline’lar, toplu işler, ETL sistemleri veya büyük veri çıkarmalarını (> 100,000 satır) işleyen çalışan görevler oluşturuyorsunuz.
- Sunucularınız, elektronik tablo serileştirme veya seriden çıkarma sırasında bellek yetersizliği (OOM) hataları alıyor.
- Büyük, tekrarlayan finansal modeller veya veri dışa aktarımları için S3/blob depolama alanını ve ağ geçiş süresini en aza indirmeniz gerekiyor.
XLSB’ye geçiş genellikle dışa aktarma hizmetinizdeki bir yapılandırma dizesini değiştirmek kadar basittir, ancak normalde haftalar süren kod optimizasyonu gerektiren 3 ila 5 katlık verimlilik artışını sağlar.
Sıkça Sorulan Sorular (SSS)
**Q1: Bir XLSB dosyası, bir XLSX dosyasıyla aynı satır ve sütun limitlerini tam olarak destekliyor mu? Evet; hem XLSB hem de XLSX, çalışma sayfası başına 1.048.576 satır ve 16.384 sütun olmak üzere aynı ızgara sınırını paylaşır.
**Q2: Bir XLSB dosyası, dosya uzantısını değiştirmeden VBA makrolarını güvenli bir şekilde depolayabilir mi?
Evet, XLSX’in (kod çalıştırmak için XLSM olarak kaydetmeyi gerektirdiği) aksine, XLSB aynı .xlsb dosya formatı içinde ikili VBA makro depolamayı yerel olarak destekler.
**Q3: Her iki format da zaten ZIP sıkıştırmasıyla geldiği halde, bir dosyayı XLSB olarak kaydetmek neden boyutunu azaltıyor? XLSB, ayrıntılı metin işaretleme etiketlerini ortadan kaldırır ve hücre konumlarını, kayıtları ve ham sayısal değerleri sıkı ikili bayt akışlarına kodlayarak, düz XML dizgelerinden çok daha yoğun bir şekilde sıkıştırır.
**Q4: Google Sheets, XLSB dosyalarını doğrudan içe aktarabilir ve düzenleyebilir mi?
Hayır; Google Sheets, .xlsb dosyalarını yerel olarak doğrudan açamaz veya dönüştüremez; içe aktarmadan önce bunları .xlsx veya CSV formatına dönüştürmeniz gerekir.
**Q5: XLSB dosyaları, XLSX dosyalarına göre veri bozulmasına daha mı yatkındır? XML dosyaları kısmen bozulduğunda bazen bir metin düzenleyicisiyle manuel olarak incelenebilir veya onarılabilirken, ikili BIFF12 akışları kesin bayt ofsetleri gerektirir ve yapısal sektörler zarar gördüğünde manuel olarak kurtarmak zordur.