Останнє оновлення: 20 серпня 2026
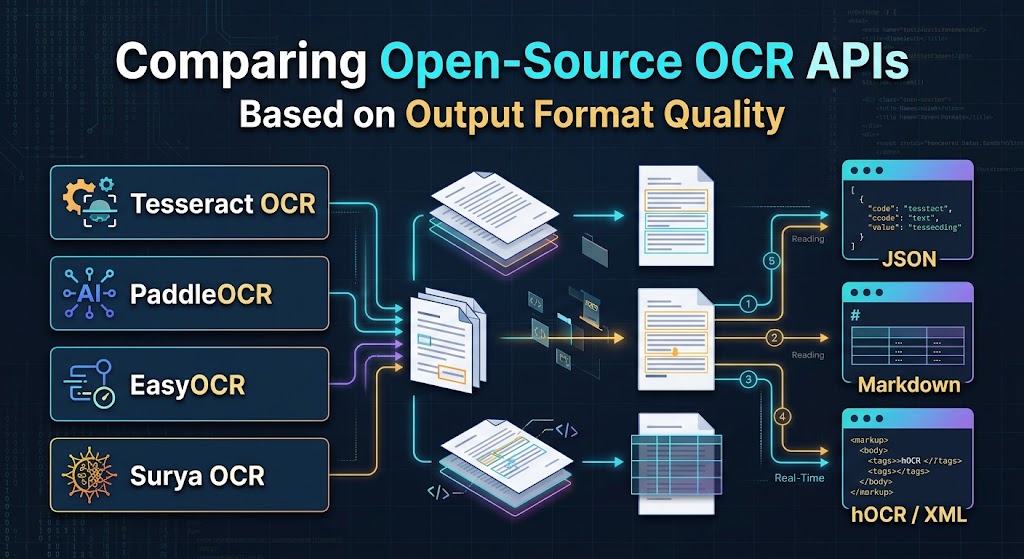
Порівняння відкритих OCR API за якістю формату виводу
Коли інженери оцінюють движки оптичного розпізнавання символів (OCR), показники помилки символів (CER) та помилки слів (WER) зазвичай домінують у бенчмарках. Хоча точність розпізнавання є важливою, вона вирішує лише половину проблеми у виробництві.
Якщо ви аналізуєте складні багатостовпчикові PDF, витягуєте позиції з чеків або імпортуєте технічні документи у конвеєр вбудовування LLM, сирі текстові дампи створюють величезне інженерне навантаження. Рядок символів без розуміння розмітки, логічного порядку читання або координатних даних змушує вашу команду писати крихкі евристичні парсери.
Справжнім відмінником сучасних робочих процесів з документами є якість вихідного формату: наскільки послідовно та чисто движок надає координати, порядок читання, структурну ієрархію та табличні дані.
Нижче наведено інженерно-орієнтоване порівняння чотирьох провідних OCR з відкритим кодом движків—Tesseract, PaddleOCR, EasyOCR, і Surya OCR—що оцінює, як їхні виходи поводяться в автоматизованих конвеєрах.
Загальні формати виводу: Що насправді потрібно інженерам
Кожен OCR API пакує виявлений текст по‑різному. Розуміння цих форматів допомагає визначити, скільки пост‑обробки потрібна вашій конвеєрній системі:
- Plain Text (
.txt): Найпростіше представлення. Воно видаляє всю позиційну метадані та зводить багатостовпчикові макети до горизонтального читання, що може перемішати абзаци. - Archival Standards (
hOCR,ALTO XML): Формати на основі XML/HTML, що є стандартом у бібліотечному архівуванні. Вони вбудовують координати, оцінки шрифтів та рівні впевненості всередину DOM‑вузлів. Надзвичайно надійні для відтворення документів, але громіздкі для мікросервісів. - Structured JSON: Типовий вибір для сучасних веб‑бекендів. Надає масиви координат (обмежувальні рамки або полігони), рівні впевненості та ієрархічні структури блоків/рядків/слів.
- Markdown (
.md) / HTML Tables: Сучасний стандарт для Retrieval‑Augmented Generation (RAG). Зберігає семантичні розділи (заголовки, списки, жирний текст) та табличні матриці без потреби у подальшій просторовій реконструкції.
1. Tesseract OCR
Підтримуваний Google, Tesseract залишається фундаментальним робочим конем відкритого OCR. Його архітектура сильно спирається на традиційні алгоритми сегментації сторінок, доповнені LSTM‑базованим двигуном символів.
Нативні формати виводу
- Основні вихідні дані: Звичайний текст, hOCR (HTML), ALTO XML, TSV (Tab-Separated Values) та searchable PDF/A.
- Обізнаність про розмітку: Правило‑орієнтовані евристики через режими сегментації сторінок (PSM).
Аналіз формату виводу
- Де він переважає: Експорти
TSVтаhOCRу Tesseract стандартизовані та передбачувані. Один експорт TSV повертає структуровані стовпці дляlevel,page_num,block_num,par_num,line_num,word_num,left,top,width,heightтаconf. Якщо ви конвертуєте паперові архіви у пошукові PDF або потребуєте суворого дотримання інституційних стандартів, Tesseract обробляє це нативно без спеціального коду. - Де він недоліковий: У Tesseract немає вбудованого JSON API. Використання його виводу в Python або Node.js вимагає парсингу XML/TSV файлів або використання обгорток типу
pytesseract. Його движок розмітки також має труднощі з нестандартним колонковим потоком, часто змішуючи текст з сусідніх колонок, якщо не надати ручні обрізки меж.
Tesseract Output Profile:
├── Plain Text: Clean for standard single-column pages
├── XML / hOCR: First-class, rock-solid support
├── JSON: Requires custom wrappers or TSV-to-JSON transforms
└── Markdown / Tables: Poor (requires custom reconstruction)
2. PaddleOCR
Підтримуваний фреймворком PaddlePaddle від Baidu, PaddleOCR здобув широке впровадження завдяки своїм легким моделям, широкому охопленню багатомовності та спеціалізованому набору інструментів для аналізу документів (PP-Structure).
Нативні формати виводу
- Основні результати: Python lists/dictionaries, raw JSON, visualization overlays, and structured HTML via PP-Structure.
- Ознака розмітки: Висока (використовуючи моделі глибокого навчання для розбору макету, класифікації орієнтації та відновлення таблиць).
Аналіз формату виводу
- Де воно переважає: Стандартний PaddleOCR повертає координати 4‑точкових полігонів (
[[x1, y1], [x2, y2], [x3, y3], [x4, y4]]) разом з рядками тексту та оцінками впевненості. Це ефективно обробляє спотворений або вигнутий текст. Проте справжня сила полягає у наборі PP-Structure, який виявляє регіони макету (заголовок, текст, таблиця, рисунок) і безпосередньо перетворює таблиці у валідні HTML‑рядки (<table>...</table>). Це усуває необхідність вручну обчислювати об’єднання клітинок за допомогою обмежувальних рамок. - Де воно не справляється: Базовий API повертає вкладені масиви, у яких відсутні стандартні ключі властивостей у різних версіях. Для структурованих застосувань розробники зазвичай пишуть проміжний адаптер для стандартизації імен полів (
bbox,text,confidence).
PaddleOCR Output Profile:
├── Plain Text: Clean across multiple orientations
├── XML / hOCR: Limited (JSON is the preferred interchange format)
├── JSON: Highly detailed with 4-point polygons
└── Markdown / Tables: Excellent (direct HTML table generation via PP-Structure)
3. EasyOCR
Створений на базі PyTorch компанією JaivenAI, EasyOCR розроблений для швидкого впровадження розробниками. Він об’єднує CRAFT (Character Region Awareness for Text Detection) з мережами розпізнавання на основі глибокого навчання в мінімальний API.
Нативні формати виводу
- Основні результати: Python‑списки, що містять кортежі координат, розпізнаних рядків та значень впевненості.
- Обізнаність про макет: Низька до середньої (лише виявлення рядків тексту; без структурного розбору на рівні документа).
Аналіз формату виводу
- Де воно переважає: Простота об’єкта повернення не має рівних:
[
    (
        [[x1, y1], [x2, y2], [x3, y3], [x4, y4]],
        "Total Balance Due",
        0.9842,
    )
]
Перетворення цього виводу у стандартну REST‑відповідь або його серіалізація безпосередньо у GeoJSON/власні схеми займає лише кілька рядків коду. Він працює надійно з текстом у природних сценах, номерними знаками та окремими фрагментами документів.
- Де воно недоліки: EasyOCR не виконує цілісний аналіз макету документа. Він не розпізнає таблиці, ієрархії заголовків або порядок читання у складних колонках. Використання EasyOCR на двоколонковій академічній статті часто призводить до переплетених фрагментів тексту, якщо не поєднано його з попередньою моделлю виявлення макету (наприклад, YOLO або LayoutLM).
EasyOCR Output Profile:
├── Plain Text: Good for isolated text blocks
├── XML / hOCR: Not supported natively
├── JSON: Trivial to generate from Python tuples
└── Markdown / Tables: None (requires external layout pipelines)
4. Surya OCR
Surya — це сучасний OCR‑фреймворк на базі глибокого навчання, розроблений спеціально для розуміння складних документів та конвеєрів обробки LLM.
Нативні формати виводу
- Основні результати: JSON‑структури, змодельовані за допомогою Pydantic, індекси логічного порядку читання, області обмеження макету та полігони виявлення рядків.
- Обізнаність про макет: Надзвичайно висока (аналіз макету на основі глибокого навчання та сортування порядку читання).
Аналіз форматів виводу
- Де воно перевершує: Surya безпосередньо вирішує проблеми сучасної інженерії ШІ. Замість припущення, що документи читаються зверху вниз, зліва направо, Surya використовує спеціальну модель для передбачення порядку читання. Вона групує рядки в логічні семантичні блоки, природно обробляє багатостовпчикові ділянки та виводить типізовані структури за допомогою Pydantic. Це робить подальше засвоєння у векторних базах даних та конвертерах Markdown прямим і надійним.
- Де воно має недоліки: Як новіший, більш важкий фреймворк на базі PyTorch, Surya потребує виділених GPU-ресурсів, щоб відповідати пропускній здатності оптимізованих C++ движків, таких як Tesseract, або квантизованих моделей Paddle. Він не орієнтується на старі архівні стандарти, такі як hOCR або ALTO.
Surya Output Profile:
├── Plain Text: Naturally ordered according to human reading flow
├── XML / hOCR: Not supported
├── JSON: Fully typed, modern Pydantic schemas
└── Markdown / Tables: Clean semantic blocks ideal for Markdown synthesis
Матриця порівняння «один проти одного»
| Можливості / Формат | Tesseract OCR | PaddleOCR (PP-Structure) | EasyOCR | Surya OCR |
|---|---|---|---|---|
| Рідний hOCR / ALTO XML | Рідна підтримка | Тільки сторонні | Немає | Немає |
| Геометрія обмежувальної рамки | Вирівняно за осями (x, y, w, h) | Полігон з 4 точок | Полігон з 4 точок | Полігон + блоки розмітки |
| Парсинг таблиці | Тільки координатний TSV | HTML-рядки таблиці | Немає | Сітки координат клітинок |
| Виявлення порядку читання | На основі правил (переривання при багатостовпчикових) | ML-аналіз розмітки | Базове групування рядків | Спеціальна модель порядку читання |
| Прямі схеми JSON | Потрібне перетворення | Python словник / JSON | Python список / JSON | Типізовані моделі Pydantic |
| Ідеальна цільова система | Архівні PDF, застаріла DMS | Дані форм/квитанцій, ERP-системи | Швидкі скрипти, текст на сцені | Імпорт LLM, архітектури RAG |
Рекомендації щодо конвеєра: який обрати?
- Виберіть Tesseract якщо ваші вимоги до відповідності вимагають стандартизованих
hOCR,ALTO XMLабо пошукових PDF/A результатів для урядових або архівних записів. - Виберіть PaddleOCR якщо ви обробляєте операційні фінансові документи (рахунки, квитанції, податкові форми), що містять складні, безрамкові таблиці, які потрібно конвертувати в HTML або електронні таблиці.
- Виберіть EasyOCR якщо вам потрібна легка, Python‑подібна бібліотека для виявлення та вилучення тексту з природних зображень, вуличних знаків або обрізаних елементів інтерфейсу без складних налаштувань.
- Виберіть Surya OCR якщо ви передаєте неструктуровані бізнес-звіти, наукові статті та технічні посібники в LLM або векторний пошуковий движок, де логічний порядок читання та чисті структурні межі мають вирішальне значення.
Поширені запитання (FAQ)
1. Який відкритий формат виводу OCR найпростіший для подачі у великі мовні моделі?
JSON Surya OCR, що враховує порядок читання, та HTML‑таблиці PaddleOCR PP-Structure забезпечують найчистіші представлення для контекстів підказок LLM та індексації RAG.
2. Чи може Tesseract нативно генерувати JSON‑відповіді без сторонніх інструментів?
Ні, Tesseract нативно виводить текст, TSV, PDF та hOCR/ALTO XML; створення JSON вимагає конвертації його TSV або hOCR‑виводу за допомогою проміжного парсера.
3. Чим відрізняються координати 4‑точкових полігонів від осьових обмежувальних рамок?
Прямокутники, орієнтовані за віссю, використовують [x, y, width, height], припускаючи плоский текст, тоді як 4‑точкові полігони надають чотири пари координат для точного охоплення повернутих, спотворених або вигнутих рядків тексту.
4. Який движок виводить структури таблиць безпосередньо у код, а не у вільні координати?
Модуль PP-Structure від PaddleOCR відтворює виявлені межі таблиці у повні HTML‑теги таблиці (<table>, <tr>, <td>), уникаючи власних просторових обчислень.
5. Чому стандартний вивід EasyOCR має труднощі з багатостовпчиковими науковими статтями?
EasyOCR визначає рядки тексту на основі локальної близькості, а не глобальної ієрархії макету, через що текст з суміжних колонок переплітається, якщо його не обмежує зовнішній движок макету.