Останнє оновлення: 20 серпня 2026
Формати файлів OCR для історичних та рукописних документів
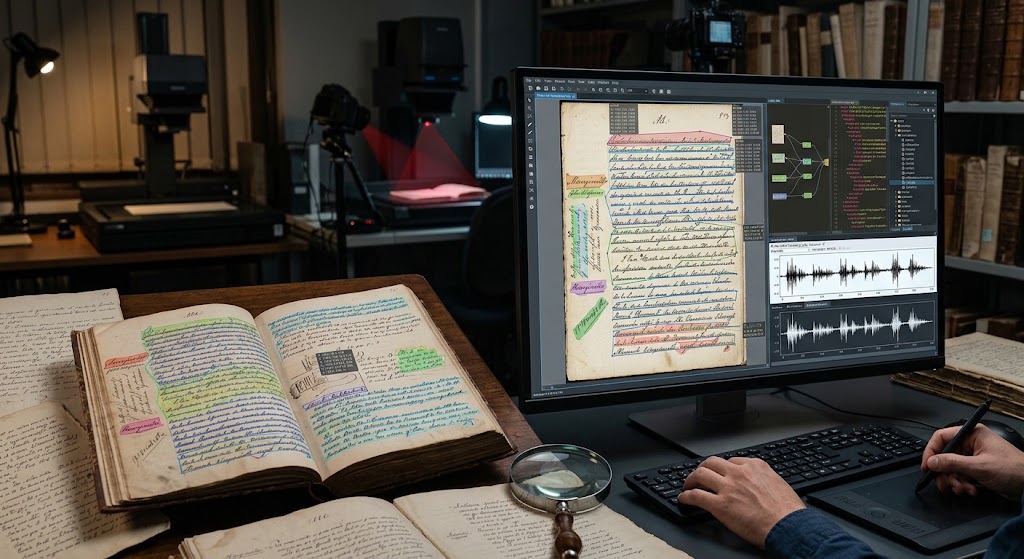
Збереження культурної спадщини шляхом оцифрування переживає ренесанс. Хоча ранні системи оптичного розпізнавання символів (OCR) були створені для обробки бездоганих, машинно надрукованих документів двадцятого століття, сучасні установи, що займаються культурною спадщиною, стикаються з набагато складнішою, багатшою задачею: середньовічними манускриптами, листуванням XIX століття курсивом, крихкими ілюмінованими фоліо та реєстрами віком у століття.
Транскрибування історичних документів вже не обмежується лише вилученням простого ASCII‑тексту. Потрібно захоплювати контекст—фізичну геометрію сторінки, криві базової лінії, виправлення просвічування, маргіналії, скорочення та палеографічну невизначеність. Ця спеціалізована галузь, часто класифікована як розпізнавання рукописного тексту (HTR), сильно залежить від формату файлу, який використовується для зберігання та обміну як координатами зображень, так і текстовими шарами.
Вибір неправильної схеми може видалити важливі дані базової лінії, порушити вирівнювання з маніфестами IIIF (International Image Interoperability Framework) або завадити довгостроковому цифровому збереженню. Ось остаточний посібник щодо провідних форматів файлів OCR та HTR для історичних документів, їх структурних переваг та того, як визначити правильний вибір для вашого архівного конвеєра.
Історична дилема: чому Звичайний текст і стандартні PDF не працюють
OCR, виконаний машинним друком, часто створює прості файли .txt або "sandwich" PDF‑файли з прихованими текстовими шарами під сканом. Для історичних рукописів і курсивного письма ці результати не підходять з трьох основних причин:
- Нелінійний текст і складні макети: Історичні писарі не дотримувалися акуратних прямокутних сіток. Текст спадає в поля, обгортає освітлені ініціали, переплітається між вставленими міжрядковими виправленнями або розташовується вертикально вздовж корешка.
- Криві та схилені базові лінії: Курсивне письмо рідко слідує жорсткій горизонтальній осі. HTR‑движки, такі як Transkribus, Kraken та eScriptorium, покладаються на багатокутні базові лінії замість обмежувальних рамок для інтерпретації скриптів з великою кількістю лігатур.
- Палеографічна складність і метадані: Архівні дослідження вимагають відстеження скорочень, історичних варіантів правопису, пошкоджених читань та оцінок впевненості на рівні рядка. Стандартні формати документів відкидають цю деталізацію.
Щоб зберегти достовірність оригінального артефакту, архівна спільнота покладається на структуровані схеми XML, розроблені для збереження топології макету разом із транскрибованим текстом.
1. PAGE XML: Золотий стандарт розпізнавання рукописного тексту (HTR)
Розроблений дослідницькою лабораторією PRImA (Pattern Recognition & Image Analysis), PAGE XML (Page Analysis and Groundtruth Elements) широко вважається передовим форматом для розпізнавання рукописного тексту та розширеного аналізу макету.
Основна архітектура
PAGE XML розглядає фізичний документ як ієрархічну структуру:
PcGts(Корінь)Page(Розміри зображення та загальний порядок читання)TextRegion(Абзаци, заголовки, примітки на полях, ключові слова)TextLineCoords(Координати полігонів навколо рядка)Baseline(Послідовність точок, що слідують за справжньою базовою лінією письма)TextEquiv(Розпізнаний текст, з необов’язковими метриками впевненості)
Чому він виділяється у історичних рукописах
- Точність полігонів та поліліній: Замість примушування символів у прямокутні рамки, PAGE XML використовує багатоточкові межі полігонів та безперервні базові лінії. Це запобігає перекриттю курсивних підйомників і спускових елементів, які можуть заважати сегментації.
- Детальні типи структури: Регіони можна точно класифікувати (наприклад,
marginalia,drop-capital,signature-mark,header,editorial-note). - Широка програмна екосистема: Вона слугує основною внутрішньою та експортною схемою для провідних HTR платформ, таких як Transkribus, eScriptorium та Kraken.
2. ALTO XML: Потужна платформа для бібліотек та архівів
ALTO (Analyzed Layout and Text Object) — це відкритий стандарт XML, який підтримується Бібліотекою Конгресу та широко використовується національними бібліотеками, включаючи Bibliothèque nationale de France (BnF) та Британську бібліотеку.
Основна архітектура
ALTO структурує макет ієрархічно від Page до PrintSpace, далі до TextBlock, TextLine та String (окремі слова або токени). Він часто упаковується у обгортку METS (Metadata Encoding and Transmission Standard), щоб пов’язати структуровані метадані з високоякісними оригінальними зображеннями.
Ключові переваги та сценарії використання
- Масові робочі процеси оцифрування: ALTO був розроблений з урахуванням промислового масштабного оцифрування газет і книг. Він чітко кодує атрибути шрифтів, координати на рівні слів, впевненість символів та пробіли.
- Сучасна підтримка HTR (ALTO 4): Раніші версії ALTO сильно спиралися на прямокутні координати (
HPOS,VPOS,WIDTH,HEIGHT). Однак, починаючи з версії ALTO 4, схема ввела полігони<Shape>та полілайнові базові лінії, заповнюючи функціональний розрив з PAGE XML для рукописних матеріалів. - Довгострокове збереження: Оскільки це офіційний стандарт, підтримуваний міжнародними бібліотечними консорціумами, ALTO гарантує довгострокову стабільність та зворотну сумісність архівного рівня.
3. hOCR: Веб-орієнтований, легковаговий стандарт
Створений Томасом Брейелем, hOCR підходить прагматично: замість створення цілком нової XML схеми, він вбудовує метадані розмітки та транскрипції безпосередньо в семантичний HTML/XHTML, використовуючи мікроформати та атрибути класу.
Типовий приклад синтаксису
<div class="ocr_page" id="page_1" title="bbox 0 0 2480 3508">
  <div class="ocr_carea" id="block_1_1">
    <p class="ocr_par" id="par_1_1">
      <span class="ocr_line" id="line_1_1" title="bbox 150 320 2200 410; baseline 0 -5">
        <span class="ocrx_word" id="word_1_1" title="bbox 150 325 380 405; x_wconf 92">Incipit</span>
      </span>
    </p>
  </div>
</div>
Переваги та недоліки історичних матеріалів
- Переваги: Браузери можуть відображати його нативно. Його легко трансформувати за допомогою чистого CSS та JavaScript, і це формат експорту за замовчуванням для движків, таких як Tesseract.
- Недоліки: Нативна підтримка складних, вільних багатоточкових базових кривих обмежена. Хоча це практично для ранніх друкованих робіт (інкунабула або чисті листи), hOCR має труднощі з хаотичними макетами рукописів та багатошаровими маргіналіями.
4. TEI-XML: Академічний та цифровий гуманітарний еталон
Формат Text Encoding Initiative (TEI) не є суворо форматом виводу OCR‑двигуна; навпаки, це провідний стандарт для критичних цифрових видань та наукового представлення літературних і історичних текстів.
Зв’язок OCR/HTR з TEI
Сучасні конвеєри рідко зупиняються на простому розпізнаванні символів. Науковці використовують інструменти, такі як Transkribus TEI Exporter, або автоматизовані XSLT‑конвеєри для перетворення PAGE XML або ALTO‑файлів у TEI‑сумісний XML:
- Скорочення розширюються (
<choice><abbr>...</abbr><expan>...</expan></choice>). - Видалення, додавання та рукописні руки формально класифікуються (
<add>,<del>,<handShift>). - Дані розмітки зберігаються разом з літературним аналізом за допомогою елементів
<facsimile>та<surface>.
Якщо ваш історичний проєкт має на меті створити інтерактивне критичне видання або семантично пошуковий науковий архів, перетворення ваших даних OCR/HTR у TEI-XML часто є необхідним кінцевим кроком.
Порівняльна матриця: формати OCR/HTR у огляді
| Функція / Критерій | PAGE XML | ALTO XML (v4+) | hOCR | TEI-XML |
|---|---|---|---|---|
| Основна галузь | Курсивний HTR і рукописи | Масова оцифровка бібліотек | Веб OCR та легкий пошук | Наукові критичні видання |
| Базова підтримка | Нативні, багатоточкові полілінії | Підтримується (з v4.0) | Базовий (Нахил/Зсув) | Через факсимільне відображення |
| Нерегулярні багатокутники | Повний | Повний | Обмежений | Через координатні елементи |
| Екосистема інструментів | Transkribus, eScriptorium | METS, Goobi, Kitodo | Tesseract, веб‑переглядачі | Oxygen, TEI Publisher |
| Орган стандартизації | PRImA Group / Open | Бібліотека Конгресу | Специфікація спільноти | Консорціум TEI |
Практичні рекомендації: вибір вашого архівного конвеєра
Щоб створити ефективний, майбутньо‑стійкий конвеєр оцифрування:
- Для чистих рукописних манускриптів та архівів: Стандартизуйте свою транскрипцію та вилучення макету за допомогою PAGE XML. Його розрахунок базової лінії та контурування полігонів обробляють нестандартні писемні руки з мінімальною втратою даних.
- Для масштабних бібліотек та змішаних колекцій: Обирайте ALTO XML (v4.2 або вище) у поєднанні з METS. Це гарантує безшовну інтеграцію у стандартні архітектури цифрових репозиторіїв та системи управління цифровими активами (DAMS).
- Для веб‑презентації та індексів повнотекстового пошуку: Використовуйте hOCR або створюйте легкі структури GeoJSON/Web Annotation з PAGE XML, щоб керувати інтерактивними переглядачами IIIF (наприклад, Mirador або Universal Viewer) з живими текстовими накладеннями у браузері.
- Для наукових видань та палеографічних досліджень: Створіть ваш ground truth у PAGE XML, виконайте розпізнавання та передайте вихід через автоматичний конвертер, щоб згенерувати TEI-XML для редакційної розмітки.
Підбираючи структурні можливості цих форматів до палеографічних вимог вашого вихідного матеріалу, ви забезпечуєте, що кожен штрих, скорочення та історичний нюанс залишаться розбірливими протягом століть.
Поширені запитання (FAQ)
Q1. У чому фундаментальна різниця між стандартним OCR та HTR? OCR розпізнає послідовну машинно надруковану типографіку, тоді як HTR (розпізнавання рукописного тексту) використовує глибокі нейронні мережі для декодування безперервного, змінного людського рукопису та вигнутих базових ліній.
Q2. Чи може Tesseract OCR створювати PAGE XML або ALTO вихід для історичних документів? Так, Tesseract може генерувати нативний ALTO XML та hOCR вихід, а сторонні обгортки можуть конвертувати ці результати у PAGE XML.
Q3. Чому базові лінії важливіші за обмежувальні рамки у транскрипції рукописного тексту? Базові лінії відстежують природну, хвилясту лінію людської каліграфії, дозволяючи програмному забезпеченню розділяти перекриваючі підйомники та спускові елементи, які стикаються всередині жорстких обмежувальних рамок.
Q4. Як стандарт IIIF взаємодіє з цими форматами OCR‑файлів? IIIF надає зображення високої роздільної здатності через відкриті веб‑API, тоді як формати, такі як ALTO або PAGE XML, забезпечують координатні дані, які можна перетворити в анотації пошуку вмісту IIIF.
Q5. Який формат файлу найпростіший для прямого перетворення у пошуковий PDF? Як hOCR, так і ALTO XML можна поєднати з оригінальними зображеннями сторінок для створення пошукових PDF‑файлів з двома шарами за допомогою інструментів, таких як OCRmyPDF.