Останнє оновлення: 30 вересня 2026
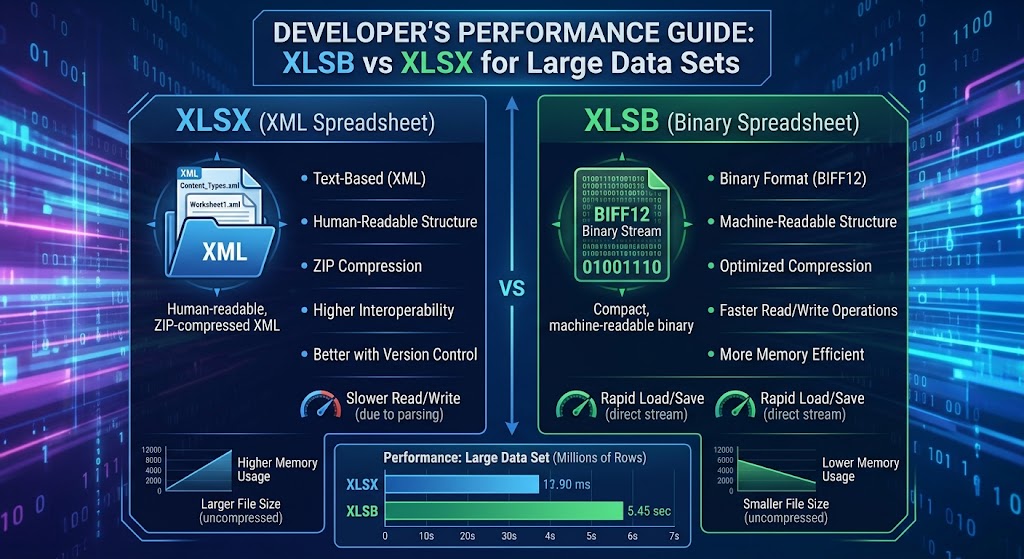
XLSB vs XLSX для великих наборів даних: Посібник розробника щодо продуктивності
Якщо ви створюєте конвеєри даних, бекенд‑звітні движки або аналітичні інструменти, які взаємодіють з Microsoft Excel, ви, ймовірно, зіткнулися з «стеною».
Користувач завантажує книгу з 450 000 рядків. Ваш сервер піднімає робочі потоки, споживання пам’яті різко зростає до гігабайтів, збірка сміття зупиняє виконання, і ваш процес перевищує час очікування. Ви перевіряєте вміст: це стандартний файл .xlsx.
Щоб вирішити цю проблему, розробники часто витрачають дні на впровадження розбиття на частини, потокових парсерів або перенесення файлів у фоні. Однак одна з найефективніших оптимізацій не потребує жодного архітектурного перепроектування: зміна розширення файлу з .xlsx на .xlsb.
У цьому посібнику ми заглибимося у внутрішню будову обох форматів, розглянемо, чому їх архітектури дають радикально різні характеристики продуктивності, порівняємо конкретні бенчмарки для Python і .NET та окреслимо чіткі правила, коли слід використовувати бінарні книги у продакшені.
1. Під капотом: OpenXML vs. BIFF12
Щоб зрозуміти, чому продуктивність так різко розходиться на великих наборах даних, нам потрібно подивитися, як кожен формат зберігає записи на диску.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Обидва файли .xlsx і .xlsb є стиснутими ZIP‑контейнерами, що відповідають Open Packaging Conventions (OPC). Якщо перейменувати будь‑який файл у .zip і розпакувати його, ви побачите знайому структуру каталогів: _rels, docProps та xl/worksheets/.
Критична різниця знаходиться всередині папки xl/worksheets/:
- XLSX зберігає листи у вигляді простого XML‑тексту (
sheet1.xml). - XLSB зберігає листи у вигляді пропрієтарних бінарних потоків (
sheet1.bin), закодованих за допомогою BIFF12 від Microsoft (Binary Interchange File Format 12).
Як XLSX кодує дані (XML DOM Overhead)
У робочому листі XLSX кожна клітинка оголошується за допомогою явних XML‑тегів:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Під час читання цього рядка ваш runtime повинен:
- Розпакувати сирий потік deflate у текст.
- Токенізувати та розпарсити символи рядка у XML DOM або потік подій SAX.
- Перевірте відкриті та закриті теги (
<c>,</c>,<v>,</v>). - Виконайте пошук рядків у окремій таблиці
sharedStrings.xml. - Розберіть ASCII‑текст “98234.55” у 64‑бітове число з плаваючою комою за стандартом IEEE 754.
Кожна окрема клітинка створює навантаження на процесор через розбір рядків, їх виділення та лексичний аналіз. Помножте це на 500 000 рядків і 30 стовпців (15 мільйонів клітинок), і процесор витрачає значно більше тактів на розбір синтаксису, ніж на обробку значень домену.
Як XLSB кодує дані (BIFF12 Binary Stream)
BIFF12 повністю відкидає серіалізацію тексту. Замість розмітки рядків дані організовані як послідовна послідовність бінарних записів змінної довжини:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Клітинка з плаваючою комою у BIFF12 не використовує рядкові представлення типу “98234.55”. Вона представляється безпосередньо:
- 2 байти для ідентифікатора запису (наприклад,
BrtCellRkабоBrtCellReal) - 4 байти для індексів стовпця/рядка
- 8 байтів, що містять необроблену структуру байтів IEEE 754 подвійної точності
Коли ваш парсер читає файл XLSB, він повністю обходить лексичний аналіз. Він читає заголовок запису, бере 8 необроблених байтів з буфера, копіює їх безпосередньо в пам’ять і просуває вказівник вперед. Не потрібно перевіряти жодних тегів, немає перетворень типу рядок‑в‑число, і немає жодних накладних витрат на декодування UTF‑8 для числових даних.
2. Кількісні еталони: диск, пам’ять та пропускна здатність
Щоб проілюструвати реальний вплив, розгляньте змодельований набір даних, що містить 750 000 рядків і 25 стовпців (комбінація міток часу, чисел з плаваючою комою, цілих чисел та кодів категорій).
Тести нижче оцінюють однакові табличні дані, збережені як у форматі XLSX, так і XLSB.
Тестове середовище
- CPU: AMD Ryzen 9 5900X (12 ядер, 24 потоки)
- RAM: 64 ГБ DDR4-3600
- Сховище: PCIe 4.0 NVMe SSD
- Час виконання: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Ключові показники продуктивності
| Метрика | XLSX (OpenXML) | XLSB (BIFF12) | Дельта / Покращення |
|---|---|---|---|
| Розмір файлу на диску | 128.4 MB | 68.2 MB | ~47% менше |
| Час збереження / серіалізації | 42.6 s | 14.1 s | 3.0x швидше |
| Час читання (Python DOM parser) | 38.2 s | 8.9 s | 4.3x швидше |
| Час читання (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x швидше |
| Пікове розподілення heap під час читання | ~1.85 GB | ~510 MB | ~72% зменшення |
Чому файли XLSB менші
Хоча обидва формати використовують стандартне ZIP-стиснення, бінарні потоки стискаються значно ефективніше, ніж роздуті XML‑тексти:
- Зайвий синтаксис усунуто: XML містить повторювані теги (
<c r=\"AA1\" s=\"1\">) у кожному записі. Хоча ZIP‑стиснення зменшує кількість повторюваних рядків, нестиснутий потік даних залишається величезним. - Числова щільність: У XML число
12345678.9012вимагає 14 байтів ASCII‑тексту. У BIFF12 воно зберігається як 8‑байтовий double (або упаковується у 4‑байтовий записRK, якщо відповідає певним правилам точності).
3. Використання пам’яті та навантаження збирача сміття
Для веб‑сервісів та мікросервісів, що обробляють одночасні запити, швидкість процесора — лише половина боротьби; використання пам’яті — це те, де програми дійсно падають.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Коли XML‑парсер обробляє файл XLSX розміром 100 МБ, йому доводиться створювати тисячі тимчасових рядкових токенів, буферів зрізів рядків та пошуків у словнику. У мовах зі збирачем сміття (Java, C#, Go, Node.js, Python) це призводить до сильної фрагментації купи та змушує середовище виконання часто зупинятись для збору сміття (GC).
Оскільки парсинг XLSB працює безпосередньо з фіксованими байтовими зрізами, парсери можуть читати дані у структури, розміщені в стеку, або у багаторазові байтові буфери. Результатом є значно зменшений обсяг пам’яті та відсутність надмірного використання алокатора під час виконання.
4. Приклади реалізації розробником
Розглянемо, як використовувати XLSB у типових інструментаріях розробників.
Python: Перехід від OpenPyXL до Calamine / PyXLSB
Стандартний pandas.read_excel('data.xlsx') за замовчуванням використовує openpyxl, який створює важке дерево в пам’яті.
Щоб обробляти великі файли XLSB з максимальною швидкістю, використовуйте рушій calamine, написаний на Rust (доступний через python-calamine і інтегрований у сучасний Pandas):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Якщо ви перебираєте величезні набори даних рядок за рядком, не завантажуючи всю матрицю у DataFrame, pyxlsb пропонує легковаговий ітератор потокової передачі:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Високопродуктивне споживання потоків
У .NET бібліотеки типу ClosedXML або EPPlus чудово підходять для стандартної генерації, але для імпорту великих файлів без вичерпання пам’яті ExcelDataReader з підтримкою XLSB працює надзвичайно швидко:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Архітектурні компроміси: Коли НЕ слід використовувати XLSB
Незважаючи на його вражаючі переваги в продуктивності, XLSB не є панацеєю. Перш ніж впроваджувати його у всій інфраструктурі, варто зважити кілька операційних компромісів:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Підтримка екосистеми та бібліотек
- XLSX: Універсальний. Практично кожна мова, бібліотека, SaaS‑інструмент (Google Sheets, Airtable, Tableau) та веб‑парсер підтримують OpenXML нативно.
- XLSB: Менш поширений. Хоча Excel, LibreOffice та зрілі бібліотеки розробників (
ExcelDataReader,pyxlsb,calamine,Aspose) підтримують його, багато легковагових пакетів або чистих веб‑базованих JavaScript‑парсерів (наприклад, старі збіркиSheetJS) мають обмежену або лише читальну підтримку.
2. Порівняння змін у Git та системах контролю версій
- XLSX: Оскільки містить текстовий XML у ZIP‑контейнері, утиліти командного рядка та Git‑хуки можуть розпаковувати та форматувати XML, створюючи читабельні структурні різниці між комітами.
- XLSB: Чисті бінарні дані. Системи контролю версій розглядають його виключно як непрозору бінарну «блоб», що усуває будь‑яку можливість детального порівняння чи злиття на рівні рядків.
3. Відображення у веб‑клієнті
Якщо ваша архітектура покладається на відображення електронних таблиць безпосередньо в браузері за допомогою WebAssembly або клієнтського JavaScript, парсери XLSX значно більш зрілі та менш схильні до рідкісних помилок відображення, ніж клієнтські бінарні парсери.
4. Сторонні конвеєри споживання даних
Якщо ви експортуєте файли для зовнішніх корпоративних клієнтів, багато суворих корпоративних політик безпеки позначають файли .xlsb. Оскільки файли BIFF12 можуть зберігати макроси VBA так само, як файли .xlsm (без потреби в окремому розширенні), деякі поштові фільтри та сканери брандмауера карантують завантаження .xlsb як потенційні загрози, що містять макроси.
6. Підсумкове порівняння: Який формат переможе?
| Функція | XLSX | XLSB | Переможець |
|---|---|---|---|
| Швидкість читання / розбору | Помірна до поганої | Блискавично швидка | XLSB |
| Швидкість запису / генерації | Високонавантажений процесором | Швидко | XLSB |
| Стиснення файлів | Добре | Відмінно (~40-50% менше) | XLSB |
| Розподіл пам’яті | Високий (Великий тиск GC) | Низький (Пряме читання байтів) | XLSB |
| Інтероперабельність інструментів | Універсальна | Високий, але вибірковий | XLSX |
| Труднощі сканування безпеки | Мінімальний | Інколи хибнопозитивні | XLSX |
| Можливість макросів | Ні (.xlsm потрібен) | Так (Підтримує макроси вбудовано) | Зв’язок |
7. Висновок розробника
Використовуйте XLSX, коли:
- Файли мають малий або середній розмір (< 50 000 рядків).
- Ваші файли мають бути оброблені сторонніми SaaS платформами або споживчими додатками (наприклад, Google Sheets).
- Ви не можете контролювати середовище кінцевого клієнта, який читає файл.
Перейдіть на XLSB, коли:
- Ви створюєте внутрішні конвеєри, пакетні завдання, ETL‑системи або робочі процеси, які обробляють великі витяги даних (> 100 000 рядків).
- Ваші сервери стикаються з помилками нестачі пам’яті (OOM) під час серіалізації або десеріалізації електронних таблиць.
- Вам потрібно мінімізувати обсяг сховища S3/blob та час мережевого транзиту для великих повторюваних фінансових моделей або експорту даних.
Перехід на XLSB часто полягає лише у зміні рядка конфігурації у вашому сервісі експорту, проте він забезпечує приріст пропускної здатності в 3‑5 разів, що зазвичай вимагає тижнів оптимізації коду.
Поширені запитання (FAQ)
**Q1: Чи підтримує файл XLSB ті ж самі обмеження рядків і стовпців, що й файл XLSX? Так; і XLSB, і XLSX мають однакову максимальну кількість рядків — 1 048 576, і стовпців — 16 384 у кожному аркуші.
**Q2: Чи може файл XLSB безпечно зберігати VBA‑макроси без зміни розширення файлу?
Так, на відміну від XLSX (який потребує збереження як XLSM для виконання коду), XLSB підтримує нативне зберігання бінарних VBA‑макросів у тому ж форматі файлу .xlsb.
**Q3: Чому збереження файлу у форматі XLSB зменшує його розмір, якщо обидва формати вже стискаються ZIP? XLSB усуває громіздкі текстові теги розмітки та кодує позиції клітинок, записи та необроблені числові значення у щільні бінарні потоки байтів, які стискаються значно ефективніше, ніж прості XML-рядки.
**Q4: Чи може Google Sheets імпортувати та редагувати файли XLSB безпосередньо?
Ні; Google Sheets не може нативно відкривати або конвертувати файли .xlsb безпосередньо, тому вам потрібно конвертувати їх у .xlsx або CSV перед імпортом.
**Q5: Чи більш схильні файли XLSB до пошкодження даних, ніж файли XLSX? Хоча XML‑файли іноді можна вручну переглянути або відновити за допомогою текстового редактора при частковому пошкодженні, бінарні потоки BIFF12 вимагають точних байтових зсувів і їх важко відновити вручну, якщо пошкоджені структурні сектори.