Cập nhật lần cuối: 30 Sept, 2026
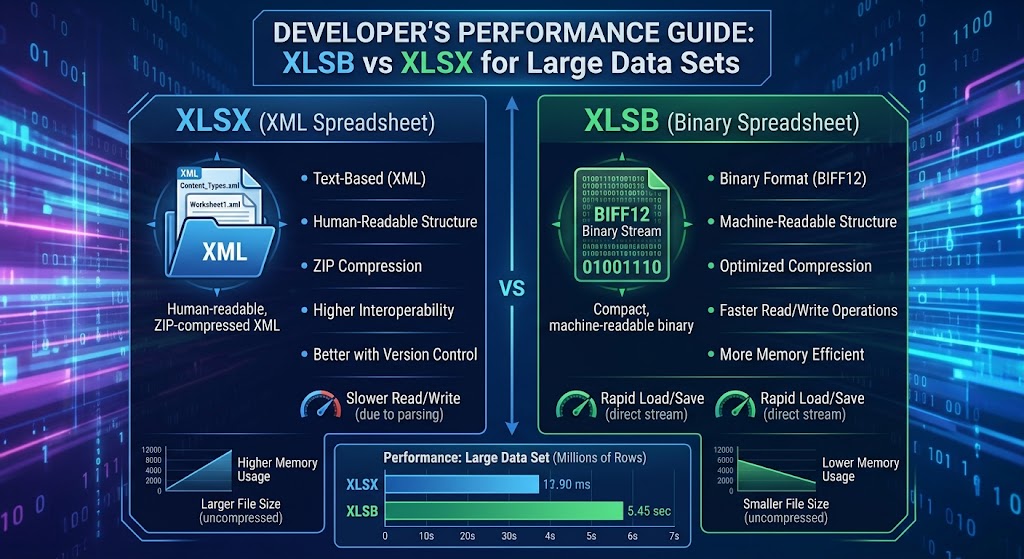
XLSB vs XLSX cho Bộ Dữ Liệu Lớn: Hướng Dẫn Hiệu Suất Dành Cho Nhà Phát Triển
Nếu bạn xây dựng các pipeline dữ liệu, công cụ báo cáo backend, hoặc công cụ phân tích giao tiếp với Microsoft Excel, bạn có thể đã gặp phải “bức tường”.
Một người dùng tải lên một workbook có 450.000 dòng. Máy chủ của bạn khởi tạo các luồng công nhân, mức tiêu thụ bộ nhớ tăng lên tới gigabyte, quá trình thu gom rác làm đóng băng thời gian chạy, và quá trình thực thi của bạn bị hết thời gian. Bạn kiểm tra payload: đó là một tệp .xlsx tiêu chuẩn.
Để giải quyết vấn đề này, các nhà phát triển thường mất hàng ngày để triển khai việc chia thành các khối, các bộ phân tích luồng, hoặc chuyển tải tệp sang các worker nền. Tuy nhiên, một trong những tối ưu hóa hiệu quả nhất không yêu cầu thiết kế kiến trúc lại: thay đổi phần mở rộng tệp từ .xlsx sang .xlsb.
Trong hướng dẫn này, chúng tôi sẽ khám phá sâu bên trong cả hai định dạng, xem xét lý do tại sao kiến trúc nội bộ của chúng tạo ra các đặc tính hiệu năng khác nhau một cách đáng kể, so sánh các benchmark cụ thể trên Python và .NET, và đưa ra các quy tắc rõ ràng về thời điểm triển khai workbook nhị phân trong môi trường sản xuất.
1. Bên Trong: OpenXML vs. BIFF12
Để hiểu tại sao hiệu năng lại khác biệt đến mức đáng kể trên các bộ dữ liệu lớn, chúng ta phải xem xét cách mỗi định dạng lưu trữ các bản ghi trên đĩa.
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
Cả các tệp .xlsx và .xlsb đều là các container ZIP được nén tuân theo Open Packaging Conventions (OPC). Nếu bạn đổi tên bất kỳ tệp nào thành .zip và giải nén, bạn sẽ thấy cấu trúc thư mục quen thuộc: _rels, docProps, và xl/worksheets/.
Sự khác biệt quan trọng nằm trong thư mục xl/worksheets/:
- XLSX lưu các sheet dưới dạng văn bản XML thuần (
sheet1.xml). - XLSB lưu các sheet dưới dạng luồng nhị phân độc quyền (
sheet1.bin), được mã hoá bằng BIFF12 của Microsoft (Binary Interchange File Format 12).
Cách XLSX Mã hoá Dữ liệu (XML DOM Overhead)
Trong một worksheet XLSX, mỗi ô được khai báo bằng các thẻ XML rõ ràng:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
Khi đọc hàng này, môi trường thực thi của bạn phải:
- Giải nén luồng deflate thô thành văn bản.
- Phân tách và phân tích các ký tự chuỗi thành một DOM XML hoặc luồng sự kiện SAX.
- Xác thực các thẻ mở và đóng (
<c>,</c>,<v>,</v>). - Giải quyết việc tra cứu chuỗi từ bảng
sharedStrings.xmlriêng biệt. - Phân tích văn bản ASCII
"98234.55"thành số thực dấu phẩy động 64-bit IEEE 754.
Mỗi ô riêng lẻ đều gây tốn tài nguyên CPU cho việc phân tích chuỗi, cấp phát chuỗi và phân tích từ vựng. Nhân điều này với 500.000 hàng và 30 cột (15 triệu ô), và CPU tiêu tốn rất nhiều chu kỳ hơn cho việc phân tích cú pháp so với xử lý các giá trị miền.
Cách XLSB Mã hoá Dữ liệu (BIFF12 Binary Stream)
BIFF12 loại bỏ hoàn toàn việc tuần tự hoá văn bản. Thay vì đánh dấu chuỗi, dữ liệu được sắp xếp thành một chuỗi tuần tự các bản ghi nhị phân có độ dài biến đổi:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
Một ô số thực trong BIFF12 không sử dụng biểu diễn chuỗi như "98234.55". Nó được biểu diễn trực tiếp:
- 2 byte cho ID bản ghi (ví dụ:
BrtCellRkhoặcBrtCellReal) - 4 byte cho chỉ số cột/hàng
- 8 byte chứa cấu trúc byte thô, độ chính xác đôi IEEE 754
Khi trình phân tích của bạn đọc một tệp XLSB, nó bỏ qua hoàn toàn việc phân tích từ vựng. Nó đọc tiêu đề bản ghi, lấy 8 byte thô từ bộ đệm, sao chép chúng trực tiếp vào bộ nhớ và di chuyển con trỏ lên. Không có thẻ nào cần xác thực, không có chuyển đổi kiểu chuỗi sang số, và không có chi phí giải mã UTF-8 cho dữ liệu số.
2. Các tiêu chuẩn định lượng: Đĩa, Bộ nhớ và Thông lượng
Để minh họa tác động thực tế, hãy xem xét một bộ dữ liệu mô phỏng chứa 750,000 hàng và 25 cột (sự kết hợp của dấu thời gian, số thực dấu chấm động, số nguyên và mã danh mục).
Các bài kiểm tra dưới đây đánh giá dữ liệu bảng giống nhau được lưu dưới dạng XLSX và XLSB.
Môi trường Kiểm thử
- CPU: AMD Ryzen 9 5900X (12 lõi, 24 luồng)
- RAM: 64 GB DDR4-3600
- Lưu trữ: PCIe 4.0 NVMe SSD
- Thời gian chạy: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
Các chỉ số Hiệu suất chính
| Chỉ số | XLSX (OpenXML) | XLSB (BIFF12) | Delta / Cải thiện |
|---|---|---|---|
| Kích thước tệp trên đĩa | 128.4 MB | 68.2 MB | ~47% nhỏ hơn |
| Thời gian Lưu / Tuần tự hoá | 42.6 s | 14.1 s | Nhanh hơn 3.0x |
| Thời gian Đọc (Python DOM parser) | 38.2 s | 8.9 s | Nhanh hơn 4.3x |
| Thời gian đọc (Rust/C Engine) | 6.4 s | 1.9 s | 3.3x nhanh hơn |
| Bộ nhớ Heap tối đa trong quá trình đọc | ~1.85 GB | ~510 MB | ~72% giảm |
Tại sao Tệp XLSB Nhỏ hơn
Trong khi cả hai định dạng đều sử dụng nén ZIP tiêu chuẩn, các luồng nhị phân nén hiệu quả hơn nhiều so với văn bản XML phình to:
- Cú pháp dư thừa được loại bỏ: XML chứa các thẻ lặp lại (
<c r=\"AA1\" s=\"1\">) trên mỗi bản ghi. Trong khi nén ZIP giảm bớt các chuỗi lặp lại, luồng dữ liệu chưa nén vẫn rất lớn. - Mật độ số: Trong XML, số
12345678.9012cần 14 byte văn bản ASCII. Trong BIFF12, nó được lưu dưới dạng số thực 8-byte (hoặc nén vào bản ghiRK4-byte nếu phù hợp với các quy tắc độ chính xác cụ thể).
3. Dấu chân bộ nhớ và áp lực thu gom rác
Đối với các dịch vụ web và microservice xử lý các yêu cầu đồng thời, tốc độ CPU chỉ là một nửa cuộc chiến; dấu chân bộ nhớ là nơi các ứng dụng thực sự gặp khó khăn.
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
Khi một trình phân tích XML xử lý tệp XLSX 100 MB, nó phải tạo ra hàng ngàn token chuỗi tạm thời, bộ đệm cắt chuỗi và tra cứu từ điển. Trong các ngôn ngữ có thu gom rác (Java, C#, Go, Node.js, Python), điều này tạo ra sự phân mảnh heap cực độ và đẩy thời gian chạy vào các khoảng dừng Thu Gom Rác (GC) thường xuyên.
Vì việc phân tích XLSB hoạt động trực tiếp trên các đoạn byte có độ rộng cố định, các bộ phân tích có thể đọc dữ liệu vào các cấu trúc được cấp phát trên stack hoặc các bộ đệm byte có thể tái sử dụng. Kết quả là dung lượng bộ nhớ giảm đáng kể và không gây thrashing cho bộ cấp phát runtime.
4. Ví dụ triển khai cho nhà phát triển
Hãy xem cách tận dụng XLSB trong các chuỗi công cụ phổ biến của nhà phát triển.
Python: Di chuyển từ OpenPyXL sang Calamine / PyXLSB
Mặc định pandas.read_excel('data.xlsx') sử dụng openpyxl, tạo ra một cây dữ liệu nặng trong bộ nhớ.
Để xử lý các tệp XLSB lớn với tốc độ tối đa, hãy sử dụng engine calamine được hỗ trợ bởi Rust (có sẵn qua python-calamine và được tích hợp vào Pandas hiện đại):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
Nếu bạn đang duyệt qua các tập dữ liệu khổng lồ theo từng hàng mà không tải toàn bộ ma trận vào DataFrame, pyxlsb cung cấp một iterator streaming nhẹ:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET: Nhập luồng hiệu suất cao
Trong .NET, các thư viện như ClosedXML hoặc EPPlus rất tốt cho việc tạo file tiêu chuẩn, nhưng để nhập các tệp lớn mà không gây cạn kiệt bộ nhớ, ExcelDataReader hỗ trợ XLSB lại cực kỳ nhanh:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. Các đánh đổi kiến trúc: Khi không nên sử dụng XLSB
Mặc dù có những lợi thế về hiệu năng vượt trội, XLSB không phải là giải pháp toàn diện. Bạn nên cân nhắc một số đánh đổi vận hành trước khi áp dụng nó trên toàn bộ hệ thống của mình:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. Hệ sinh thái và hỗ trợ thư viện
- XLSX: Phổ biến. Hầu như mọi ngôn ngữ, thư viện, công cụ SaaS (Google Sheets, Airtable, Tableau), và bộ phân tích web đều hỗ trợ OpenXML một cách tự nhiên.
- XLSB: Ít phổ biến hơn. Trong khi Excel, LibreOffice và các thư viện phát triển trưởng thành (
ExcelDataReader,pyxlsb,calamine,Aspose) hỗ trợ nó, nhiều gói nhẹ hoặc các bộ phân tích JavaScript thuần web (như các phiên bản cũ củaSheetJS) chỉ có hỗ trợ hạn chế hoặc chỉ đọc.
2. So sánh (diff) Git & Kiểm soát phiên bản
- XLSX: Vì nó chứa XML dạng văn bản bên trong một container ZIP, các tiện ích dòng lệnh và hook Git có thể giải nén và định dạng XML để tạo ra các diff cấu trúc có thể đọc được giữa các commit.
- XLSB: Dữ liệu nhị phân thuần. Các hệ thống kiểm soát phiên bản coi nó hoàn toàn là một khối nhị phân không trong suốt, loại bỏ mọi khả năng diff chi tiết hoặc hợp nhất ở mức dòng.
3. Kết xuất trên trình duyệt web
Nếu kiến trúc của bạn dựa vào việc hiển thị bảng tính trực tiếp trong trình duyệt qua WebAssembly hoặc JavaScript phía client, các bộ phân tích XLSX đáng kể hơn về độ trưởng thành và ít gặp lỗi hiển thị trường hợp đặc biệt hơn so với các bộ phân tích nhị phân phía client.
4. Các pipeline nhập liệu của bên thứ ba
Nếu bạn đang xuất tệp cho khách hàng doanh nghiệp bên ngoài, nhiều chính sách bảo mật doanh nghiệp nghiêm ngặt sẽ đánh dấu các tệp .xlsb. Vì các tệp BIFF12 có thể lưu trữ macro VBA giống hệt các tệp .xlsm (mà không cần phần mở rộng riêng), một số bộ lọc thư và trình quét tường lửa sẽ cách ly các tệp tải lên .xlsb như là các mối đe dọa tiềm năng có macro.
6. So sánh tổng quan: Định dạng nào thắng?
| Tính năng | XLSX | XLSB | Thắng |
|---|---|---|---|
| Tốc độ Đọc / Phân tích | Trung bình đến Kém | Rất nhanh | XLSB |
| Tốc độ Ghi / Tạo | Yêu cầu CPU cao | Nhanh | XLSB |
| Nén Tập Tin | Tốt | Xuất sắc (~40-50% smaller) | XLSB |
| Phân bổ bộ nhớ | Cao (Áp lực GC nặng) | Thấp (Đọc byte trực tiếp) | XLSB |
| Tính tương thích công cụ | Toàn cầu | Cao, nhưng có chọn lọc | XLSX |
| Ma sát trong quét bảo mật | Tối thiểu | Thỉnh thoảng có kết quả dương tính giả | XLSX |
| Khả năng macro | Không (.xlsm required) | Có (Hỗ trợ macro một cách tự nhiên) | Hòa |
7. Phán quyết của nhà phát triển
Sử dụng XLSX khi:
- Các tệp có kích thước nhỏ đến vừa (< 50,000 rows).
- Các tệp của bạn phải được nhập bởi các nền tảng SaaS của bên thứ ba hoặc các ứng dụng tiêu dùng (ví dụ: Google Sheets).
- Bạn không thể kiểm soát môi trường của khách hàng cuối khi đọc tệp.
Chuyển sang XLSB khi:
- Bạn đang xây dựng các pipeline nội bộ, công việc batch, hệ thống ETL, hoặc các tác vụ worker xử lý các trích xuất dữ liệu khổng lồ (> 100,000 rows).
- Các máy chủ của bạn đang gặp lỗi hết bộ nhớ (OOM) trong quá trình tuần tự hoá hoặc giải tuần tự hoá bảng tính.
- Bạn cần giảm thiểu dung lượng lưu trữ S3/blob và thời gian truyền mạng cho các mô hình tài chính định kỳ lớn hoặc việc xuất dữ liệu.
Việc chuyển sang XLSB thường chỉ đơn giản là thay đổi một chuỗi cấu hình trong dịch vụ xuất dữ liệu của bạn, nhưng nó mang lại mức tăng năng suất từ 3x đến 5x, thường đòi hỏi hàng tuần tối ưu mã.
Câu hỏi thường gặp (FAQ)
**Q1: Một tệp XLSB có hỗ trợ cùng giới hạn hàng và cột chính xác như tệp XLSX không? Có; cả XLSB và XLSX đều có cùng giới hạn lưới chính xác là 1,048,576 hàng và 16,384 cột cho mỗi bảng tính.
**Q2: Liệu tệp XLSB có thể lưu trữ macro VBA một cách an toàn mà không cần thay đổi phần mở rộng tệp không?
Có, không giống như XLSX (cần lưu dưới dạng XLSM để thực thi mã), XLSB hỗ trợ lưu trữ macro VBA nhị phân một cách nguyên bản trong cùng định dạng tệp .xlsb.
**Q3: Tại sao lưu tệp dưới dạng XLSB lại giảm kích thước nếu cả hai định dạng đã được nén ZIP? XLSB loại bỏ các thẻ đánh dấu văn bản dài dòng và mã hoá vị trí ô, bản ghi và các giá trị số thô thành các luồng byte nhị phân chặt chẽ, nén lại dày đặc hơn nhiều so với các chuỗi XML thuần.
**Q4: Google Sheets có thể nhập và chỉnh sửa tệp XLSB trực tiếp không?
Không; Google Sheets không thể mở hoặc chuyển đổi tệp .xlsb một cách tự nhiên, yêu cầu bạn phải chuyển chúng sang .xlsx hoặc CSV trước khi nhập.
**Q5: Các tệp XLSB có dễ bị hỏng dữ liệu hơn so với tệp XLSX không? Trong khi các tệp XML đôi khi có thể được kiểm tra hoặc sửa chữa thủ công bằng trình soạn thảo văn bản khi bị hỏng một phần, các luồng nhị phân BIFF12 yêu cầu các offset byte chặt chẽ và rất khó khôi phục thủ công nếu các sector cấu trúc bị hỏng.