最后更新: 2026年9月30日
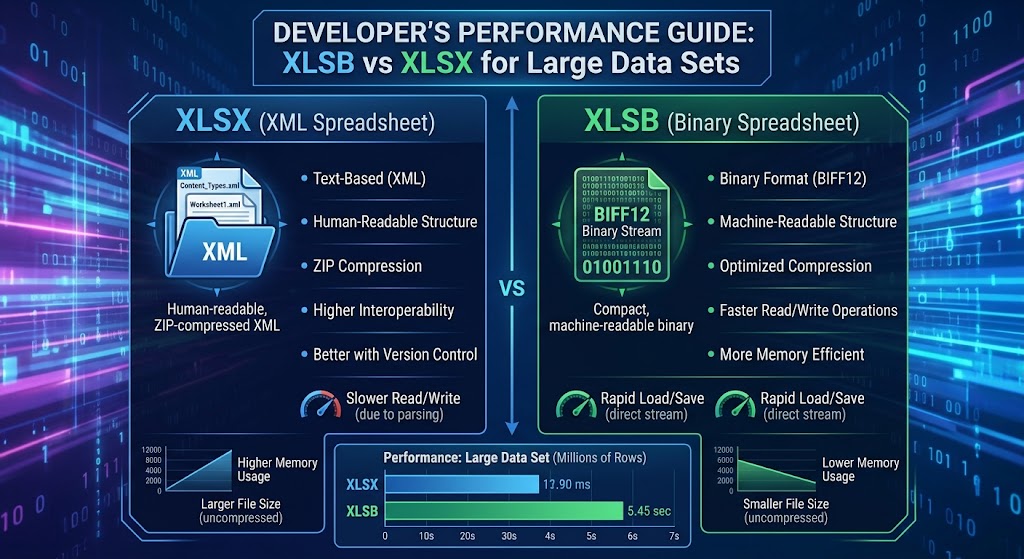
XLSB vs XLSX 大型数据集:开发者性能指南
如果您构建数据管道、后端报表引擎或与 Microsoft Excel 交互的分析工具,您很可能已经碰到“瓶颈”。
用户上传了一个包含 450,000 行的工作簿。您的服务器启动工作线程,内存消耗飙升至数 GB,垃圾回收冻结了运行时,导致执行超时。您检查负载:它是一个标准的 .xlsx 文件。
为了解决此问题,开发者通常会花费数天时间实现分块、流式解析器或将文件卸载到后台工作者。然而,最有效的优化之一无需任何架构重新设计:只需将文件扩展名从 .xlsx 改为 .xlsb。
在本指南中,我们深入两种格式的内部结构,探讨它们的内部架构为何导致截然不同的性能特性,比较 Python 和 .NET 下的具体基准测试,并概述在生产环境中何时部署二进制工作簿的明确规则。
1. 深入内部:OpenXML 与 BIFF12
要理解为何在大数据集上性能会出现如此显著的差异,我们必须查看每种格式在磁盘上存储记录的方式。
       ┌────────────────────────┐         ┌────────────────────────┐
       │     sample.xlsx        │         │      sample.xlsb       │
       │ (ZIP Archive Wrapper)  │         │ (ZIP Archive Wrapper)  │
       └───────────┬────────────┘         └───────────┬────────────┘
                   │                                  │
       ┌───────────▼────────────┐         ┌───────────▼────────────┐
       │   sheet1.xml (UTF-8)   │         │    sheet1.bin (BIFF12) │
       │  Verbose ASCII Tags    │         │ Structured Byte Stream │
       │  <c r="A1"><v>42</v>   │         │ [Opcode][Len][Payload] │
       └────────────────────────┘         └────────────────────────┘
.xlsx 和 .xlsb 文件都是符合开放包装约定(OPC)的压缩 ZIP 容器。如果将任意文件重命名为 .zip 并解压,你会看到熟悉的目录结构:_rels、docProps 和 xl/worksheets/。
关键的区别在于 xl/worksheets/ 文件夹内部:
- XLSX 将工作表存储为纯 XML 文本(
sheet1.xml)。 - XLSB 将工作表存储为专有的二进制流(
sheet1.bin),使用 Microsoft 的 BIFF12(二进制互换文件格式 12)进行编码。
如何 XLSX 编码数据(XML DOM 开销)
在 XLSX 工作表中,每个单元格都使用显式的 XML 标签声明:
<row r="1" spans="1:2">
    <c r="A1" t="s">
        <v>142</v>
    </c>
    <c r="B1">
        <v>98234.55</v>
    </c>
</row>
读取此行时,运行时必须:
- 将原始的 deflate 流解压为文本。
- 对字符串字符进行分词并解析为 XML DOM 或 SAX 事件流。
- 验证打开和关闭标签(
<c>、</c>、<v>、</v>)。 - 从单独的
sharedStrings.xml表中解析字符串查找。 - 将 ASCII 文本
"98234.55"解析为 IEEE 754 64 位浮点数。
每个单元格都会产生字符串解析、字符串分配和词法分析的 CPU 开销。将此乘以 500,000 行和 30 列(1500 万单元格),CPU 在解析语法上的消耗远远超过处理域值的消耗。
如何 XLSB 编码数据(BIFF12 二进制流)
BIFF12 完全放弃文本序列化。数据不再使用字符串标记,而是以可变长度二进制记录的顺序序列组织:
[Record Type: 2 bytes] [Record Length: 4 bytes] [Payload: N bytes]
BIFF12 中的浮点单元格不使用类似 "98234.55" 的字符串表示,而是直接表示:
- 记录 ID 占 2 字节(例如
BrtCellRk或BrtCellReal) - 列/行索引占 4 字节
- 包含原始 IEEE 754 双精度字节结构的 8 字节
当解析器读取 XLSB 文件时,它会完全跳过词法解析。它读取记录头部,从缓冲区获取 8 个原始字节,直接复制到内存中,并向前移动指针。没有需要验证的标签,没有字符串到数字的类型转换,对数值数据也没有 UTF-8 解码开销。
2. 定量基准:磁盘、内存和吞吐量
为了说明实际影响,考虑一个包含 750,000 行和 25 列(包括时间戳、浮点数、整数和类别代码)的模拟数据集。
下面的测试评估以 XLSX 和 XLSB 两种格式保存的相同表格数据。
测试环境
- CPU: AMD Ryzen 9 5900X(12 核心,24 线程)
- 内存: 64 GB DDR4-3600
- 存储: PCIe 4.0 NVMe SSD
- 运行时: Python 3.11 (
openpyxl,pyxlsb,calamine) & .NET 8 (ExcelDataReader,ClosedXML)
关键性能指标
| 指标 | XLSX (OpenXML) | XLSB (BIFF12) | 增量 / 改进 |
|---|---|---|---|
| 磁盘上的文件大小 | 128.4 MB | 68.2 MB | ~47% 更小 |
| 保存 / 序列化时间 | 42.6 s | 14.1 s | 提升 3.0 倍 |
| 读取时间(Python DOM 解析器) | 38.2 s | 8.9 s | 提升 4.3 倍 |
| 读取时间(Rust/C 引擎) | 6.4 秒 | 1.9 秒 | 快 3.3 倍 |
| 读取期间的堆峰值分配 | ~1.85 GB | ~510 MB | 约降低 72% |
为什么 XLSB 文件更小
虽然两种格式都使用标准的 ZIP 压缩,但二进制流的压缩效率远高于臃肿的 XML 文本:
- 冗余语法已被消除: XML 在每条记录上都包含重复的标签 (
<c r=\"AA1\" s=\"1\">)。虽然 ZIP 压缩可以减轻重复字符串的影响,但未压缩的数据流仍然庞大。 - 数值密度: 在 XML 中,数字
12345678.9012需要 14 字节的 ASCII 文本。而在 BIFF12 中,它被存储为 8 字节的双精度(或如果符合特定精度规则,则打包成 4 字节的RK记录)。
3. 内存占用和垃圾回收压力
对于处理并发请求的 Web 服务和微服务来说,CPU 速度只是问题的一半;内存占用才是应用实际失效的关键所在。
XLSX Parsing Heap Profile:
[ String Buffer ] -> [ Tokenizer ] -> [ XML DOM Nodes ] -> [ Object Boxing ]
▲ Massive Gen 0/1 heap allocation -> Triggers aggressive Garbage Collection

XLSB Parsing Heap Profile:
[ Byte Buffer ] -> [ Fixed Struct Copy ] -> [ Destination Array ]
▲ Minimal allocations -> Low GC overhead
当 XML 解析器处理一个 100 MB 的 XLSX 文件时,它必须创建成千上万的临时字符串标记、字符串切片缓冲区和字典查找。在垃圾回收语言(Java、C#、Go、Node.js、Python)中,这会导致严重的堆碎片化,并使运行时频繁进入垃圾回收(GC)暂停。
因为 XLSB 解析直接在固定宽度的字节切片上操作,解析器可以将数据读取到栈分配的结构或可重用的字节缓冲区中。结果是显著降低了内存占用,并且运行时分配器不会出现抖动。
4. 开发者实现示例
让我们看看如何在常见的开发者工具链中利用 XLSB。
Python:从 OpenPyXL 迁移到 Calamine / PyXLSB
标准的 pandas.read_excel('data.xlsx') 默认使用 openpyxl,它会构建一个庞大的内存树。
要以最高速度处理大型 XLSB 文件,请使用基于 Rust 的 calamine 引擎(可通过 python-calamine 获得,并已集成到现代 Pandas 中):
import pandas as pd
import time

filename_xlsx = "large_dataset.xlsx"
filename_xlsb = "large_dataset.xlsb"

# Reading standard XLSX (uses openpyxl by default)
t0 = time.perf_counter()
df_xlsx = pd.read_excel(filename_xlsx, engine="openpyxl")
print(f"XLSX loaded in {time.perf_counter() - t0:.2f}s")

# Reading XLSB with Calamine (Rust engine)
t0 = time.perf_counter()
df_xlsb = pd.read_excel(filename_xlsb, engine="calamine")
print(f"XLSB loaded in {time.perf_counter() - t0:.2f}s")
如果你在不将整个矩阵加载到 DataFrame 中的情况下逐行遍历海量数据集,pyxlsb 提供了轻量级的流式迭代器:
from pyxlsb import open_workbook

total_sum = 0.0

with open_workbook("massive_export.xlsb") as wb:
    with wb.get_sheet(1) as sheet:
        for row in sheet:
            # Cell 0 contains an RK integer or Double float
            val = row[0].v
            if val is not None:
                total_sum += val

print(f"Aggregated Total: {total_sum}")
C# / .NET:高性能流式摄取
在 .NET 中,ClosedXML 或 EPPlus 等库非常适合标准生成,但在不耗尽内存的情况下导入大文件时,支持 XLSB 的 ExcelDataReader 速度异常快:
using System;
using System.IO;
using ExcelDataReader;

public class XlsbProcessor
{
    public static void ProcessBinarySheet(string filePath)
    {
        // ExcelDataReader automatically identifies BIFF12 from file headers
        using var stream = File.Open(filePath, FileMode.Open, FileAccess.Read, FileShare.Read);
        using var reader = ExcelReaderFactory.CreateReader(stream);

        long rowCount = 0;
        double aggregateValue = 0;

        while (reader.Read())
        {
            rowCount++;

            // Read column directly without boxing overhead where possible
            if (!reader.IsDBNull(0))
            {
                aggregateValue += reader.GetDouble(0);
            }
        }

        Console.WriteLine($"Processed {rowCount:N0} rows. Sum: {aggregateValue:F2}");
    }
}
5. 架构权衡:何时不使用 XLSB
尽管拥有压倒性的性能优势,XLSB 并非万能钥匙。在整个技术栈中强制使用之前,你应权衡多个运营取舍:
                      DECISION MATRIX

               Is file size > 50MB OR
               rows > 100,000?
                    │
         ┌──────────┴──────────┐
        YES                    NO
         │                     │
   Do third-party        Use standard XLSX
   tools strictly        (Maximum compatibility)
   require OpenXML?
         │
    ┌────┴────┐
   YES        NO
    │         │
Use XLSX   Use XLSB
(Stream)   (Max speed & efficiency)
1. 生态系统与库支持
- XLSX: 通用。几乎所有语言、库、SaaS 工具(Google Sheets、Airtable、Tableau)以及网页解析器都原生支持 OpenXML。
- XLSB: 不太常见。虽然 Excel、LibreOffice 以及成熟的开发者库(
ExcelDataReader、pyxlsb、calamine、Aspose)支持它,但许多轻量级包或纯基于网页的 JavaScript 解析器(如旧版SheetJS)仅提供有限或只读支持。
2. Git 与版本控制差异比较
- XLSX: 因为它在 ZIP 容器中包含文本 XML,命令行工具和 Git 钩子可以解压并格式化 XML,以生成可读的结构化差异(diff),用于提交之间的比较。
- XLSB: 纯二进制数据。版本控制系统将其视为不透明的二进制块,完全无法进行细粒度的差异比较或行级合并。
3. Web 客户端渲染
如果你的架构依赖于通过 WebAssembly 或客户端 JavaScript 在浏览器中直接渲染电子表格,XLSX 解析器要比客户端二进制解析器成熟得多,且不太容易出现边缘案例渲染错误。
4. 第三方摄取管道
如果您正在为外部企业客户导出文件,许多严格的公司安全策略会标记 .xlsb 文件。由于 BIFF12 文件可以像 .xlsm 文件一样存储 VBA 宏(无需额外的扩展名),一些邮件过滤器和防火墙扫描器会将 .xlsb 上传文件隔离,视为潜在的宏威胁。
6. 总结比较:哪种格式胜出?
| 功能 | XLSX | XLSB | 获胜者 |
|---|---|---|---|
| 读取/解析速度 | 中等至差 | 极快 | XLSB |
| 写入/生成速度 | CPU 密集型 | 快速 | XLSB |
| 文件压缩 | 良好 | 优秀(约缩小40-50%) | XLSB |
| 内存分配 | 高(GC压力大) | 低(直接字节读取) | XLSB |
| 工具互操作性 | 通用 | 高,但有选择性 | XLSX |
| 安全扫描摩擦 | 最小 | 偶尔出现误报 | XLSX |
| 宏功能 | 否(需要 .xlsm) | 是(原生支持宏) | 平局 |
7. 开发者的结论
在以下情况下使用 XLSX:
- 文件大小为小至中等(< 50,000 行)。
- 您的文件必须被第三方 SaaS 平台或消费类应用程序(例如 Google Sheets)导入。
- 您无法控制读取文件的最终客户端环境。
在以下情况下切换到 XLSB:
- 您正在构建内部管道、批处理作业、ETL 系统或处理大规模数据提取(> 100,000 行)的工作任务。
- 您的服务器在电子表格序列化或反序列化过程中出现内存不足(OOM)错误。
- 您需要最小化 S3/blob 存储占用和大型周期性金融模型或数据导出的网络传输时间。
切换到 XLSB 通常只需在导出服务中更改一个配置字符串,但它能够实现 3 到 5 倍的吞吐量提升,这通常需要数周的代码优化。
常见问题解答(FAQ)
**Q1: XLSB 文件是否支持与 XLSX 文件完全相同的行和列限制? 是的;XLSB 和 XLSX 在每个工作表中共享完全相同的网格上限,即 1,048,576 行和 16,384 列。
**Q2: XLSB 文件能否在不更改文件扩展名的情况下安全存储 VBA 宏?
是的,与需要另存为 XLSM 才能执行代码的 XLSX 不同,XLSB 原生支持在同一 .xlsb 文件格式中二进制存储 VBA 宏。
**Q3: 如果两种格式已经是 ZIP 压缩的,为什么将文件保存为 XLSB 能减小文件大小? XLSB 消除冗长的文本标记标签,并将单元格位置、记录和原始数值编码为紧凑的二进制字节流,其压缩密度远高于普通 XML 字符串。
**Q4: Google Sheets 能直接导入并编辑 XLSB 文件吗?
不;Google Sheets 无法原生直接打开或转换 .xlsb 文件,需要先将其转换为 .xlsx 或 CSV 再导入。
**Q5: XLSB 文件比 XLSX 文件更容易出现数据损坏吗? 虽然 XML 文件在部分损坏时有时可以使用文本编辑器手动检查或修复,但二进制 BIFF12 流需要严格的字节偏移,如果结构扇区受损,手动恢复非常困难。